เมื่อพูดถึงกระบวนการสร้างโมเดลทาง Machine Learning หรือ Deep Learning สิ่งหนึ่งที่จะไม่พูดถึงไม่ได้ คือ Optimizer ซึ่งเป็นส่วนประกอบหลักในการขับเคลื่อนให้ โมเดลเรียนรู้สิ่งที่เราต้องการ
แต่ Optimizer คืออะไรแน่ และมันสำคัญยังไง?
Why we need optimizers
ในปัจจุบัน ML, AI, และ Deep learning กลายเป็น magic words จนทำให้ หลายๆคนเข้าใจว่า โมเดล deep learning สามารถแก้ไขได้ทุกปัญหา ถ้ามีข้อมูลเพียงพอ ซึ่งเป็นจริงในเชิงทฤษฎี (Univeral approximation theorem) แต่ในเชิงปฏิบัติ มันเป็นเรื่องยากมาก เพราะ ยิ่งปัญหามีความซับซ้อน ยิ่งจำเป็นต้องใช้โมเดลที่มีขนาดใหญ่ และต้องใช้ต้องการพลังการคำนวนมหาศาล เพื่อหาความสัมพันธ์ที่จะนำไปใช้ในการแก้ปัญหาต้องการ
ดังนั้น การสอนโมเดลในเชิงปฎิบัติ จึงมีไม่ใช่การแก้สมการโดยตรง แต่เป็นปัญหาที่อยู่ในกลุ่มที่เรียกว่า Optimizing problems โดยการมองว่า โมเดลเป้าหมาย เป็นเพียงแค่ กลุ่มของตัวแปร (parameters) ซึ่งจะมาประกอบกันเป็นสมการ และให้คำตอบอะไรบางอย่างออกมา ตามข้อมูลที่รับเข้ามา
การสอนโมเดล คือ การปรับแต่งตัวแปรต่างๆในโมเดล ซึ่งมักอาศัยการค่อยๆทดลองปรับค่าต่างๆทีละเล็กทีละน้อยซ้ำๆไปเรื่อยๆ เพื่อหาตัวแปรชุดที่ดีที่สุด (หรือ จุดที่ดีพอที่ยอมรับได้)
นี่จึงเป็นเหตุผลว่า ทำไมต้องมี optimizer ซึ่งจะทำหน้าที่อัพเดตโมเดลในลู่ทางที่ทำให้โมเดลแข็งแกร่งขึ้น
The Concept of Loss
สิ่งหนึ่งที่ตามมาพร้อมๆกับ optimizer คือ คอนเซปของ “Loss” ซึ่งใช้ในการวัดผลว่า ขณะนี้ โมเดลทำหน้าที่ได้ดีแค่ไหน โดย Loss นี้ทำหน้าที่เป็นเป้าหมายของ optimizer โดย optimizer จะใช้เทคนิคต่างๆเพื่อลด loss ให้ได้มากที่สุด
โดยการนิยาม Loss นั้นอาจจะต่างกันไปสำหรับโมเดลที่ต่างกัน เช่น Cross-entropy loss สำหรับงาน Classification, MSE loss สำหรับงาน Regression,
Wasserstein loss สำหรับ WGAN, Negative sampling loss สำหรับ word2vec เป็นต้น
ทั้งนี้ หลายๆคนอาจจะมีความสับสนระหว่าง Loss และ Accuracy (หรือ evaluation score แบบอื่นๆ เช่น precision, recall, F1, BLEU, …)
Loss เป็นการวัดผลการทำงานของโมเดลในระดับย่อยๆ สำหรับข้อมูลแต่ละชิ้น เช่น ข้อมูลชิ้นที่ 1 ตอบผิดไปจากความเป็นจริง 10 แต้ม, ข้อมูลชิ้นที่ 2 ตอบผิดไป 2 แต้ม แต่ Accuracy เป็นการวัดผลการทำงานของโมเดลในภาพรวม เช่น โดยเฉลี่ยจากข้อมูลทั้งหมดแล้ว โมเดลนี้มีตอบถูกทั้งหมด 80%
Gradient Descent
เมื่อเข้าใจแล้วว่า AI model เป็นเพียงแค่กลุ่มของตัวแปร ซึ่งตัวแปรเหล่านี้จะประกอบรวมกันเป็นสมการ ซึ่งจะคำนวนบางอย่างออกมาเป็นคำตอบตามที่ต้องการ
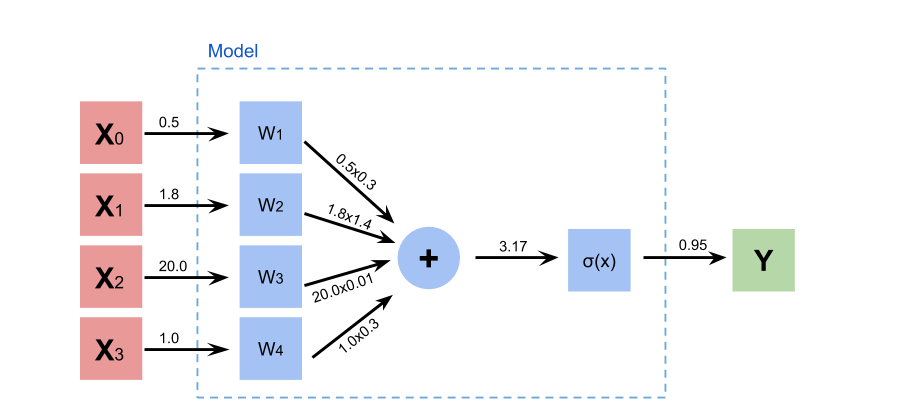
Neural Network แบบ simplify version
จากตัวอย่าง Neural network ข้างบน จะเห็นว่า โมเดลนี้ประกอบไปด้วย ตัวแปร 4 ตัว คือ W1, W2, W3, และ W4 เมื่อให้ X= [0.5, 1.8, 20, 1] ป้อนเข้าไปคำนวน โมเดลทำนายคำตอบบางอย่างออกมา Y=0.95
ถ้ากำหนด loss คือ ผลต่างระหว่างค่าที่คำนวนจากโมเดล และ ค่าที่เป็นคำตอบจริงๆ (ให้คำตอบจริงๆ y=1) จะได้ว่า \(\text{Loss} = \|1–0.95\| = 0.05\)
สิ่งที่น่าสนใจ คือ ตัวแปรแต่ละตัวในโมเดลต่างมีส่วนร่วมในการคำนวนผลลัพท์ของโมเดล ไม่ว่าจะโดยตรงหรือโดยอ้อม โดยเมื่อเปลี่ยนค่าของตัวแปรตัวใดตัวหนึ่งแน่นอนว่า จะทำให้ผลการทำนายจากโมเดลเปลี่ยนแปลง และการเปลี่ยนแปลงนี้ ก็ส่งผลไปเปลี่ยนแปลง loss อีกด้วย จึงสามารถสรุปได้ว่า
Loss เป็น function ที่ขึ้นกับตัวแปรต่างๆในโมเดล
หากพิจารณา โมเดลมีตัวแปรเพียงแค่ 2 ตัว คือ thera1, theta2 เราสามารถวาดฟังก์ชั่นระหว่าง loss และ theta1/theta2 ได้ตามรูป (กราฟนี้เป็นเพียงแค่ตัวอย่างหนึ่งของ loss function)
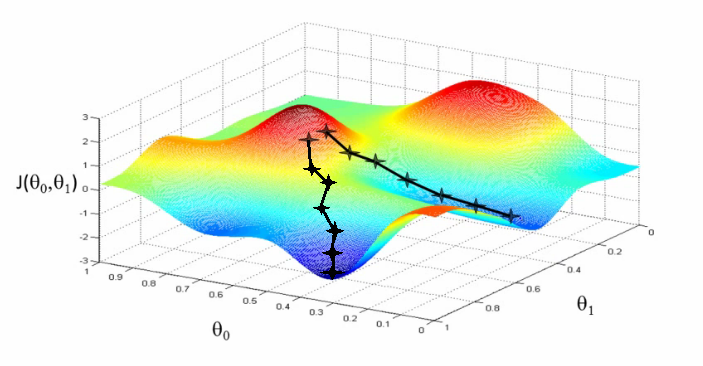
credit: https://snlpatel0012134.wixsite.com/thinking-machine/single-post/StochasticGradientDescent-SGD
เมื่อพิจารณาจากกราฟ จะเห็นว่า optimizing เสมือนเป็นการไต่กราฟ Loss เพื่อหาจุดที่ต่ำที่สุด ซึ่งการไต่กราฟนี้ สามารถทำได้ง่ายๆ วาดกราฟแล้วเลือกจุดตามที่ต้องการ หรือ ปรับ parameters แบบสุ่มๆไปเรื่อยๆ แล้วเลือกชุดของตัวแปรที่ให้ค่า loss ต่ำที่สุด แต่ในความเป็นจริง เนื่องจากโมเดลแต่ละตัวมีตัวแปรจำนวนมาก หลักหมื่น ถึง หลายสิบล้าน จึงเป็นไปไม่ได้เลยที่จะวาดกราฟ หรือ สุ่มเจอจุดที่มี Loss ต่ำที่สุดตามที่ต้องการ
เทคนิคหนึ่งที่ดีกว่าการเดิมสุ่ม คือ การไต่ตามความชันของกราฟ (gradient) คล้ายๆกับการปีนเขา โดยใช้ความชันเป็นตัวนำทางว่าควรจะเดินต่อไปทิศทางใด (ในเชิงคณิตศาสตร์ gradient จะมีทิศชี้จากจุดที่อยู่ด้านล่างไปยังจุดที่อยู่สูงกว่า ดังนั้น การไต่ตามความชัน คือ การไต่ไปทิศตรงข้ามกับ gradient) นี้จึงเป็นที่มาของเทคนิคที่เรียกว่า Gradient descent ซึ่งเขียนเป็นสมการดังนี้
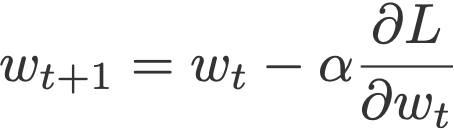
โดย
- wt แทน ค่าของ parameter ณ เวลาปัจจุบัน
- dL/dwt แทน gradient หรือ ความชันที่เกิดจากการเปลี่ยนแปลง loss เมื่อเปลี่ยนแปลง wt และเนื่องด้วยว่า gradient มีทิศตรงข้ามกับการไต่ลงไปด้านล่าง ดังนั้นในสมการจึงอัพเดตด้วย ค่าลบของ gradient
- alpha แทน learning rate (จะอธิบายในส่วนถัดไป)
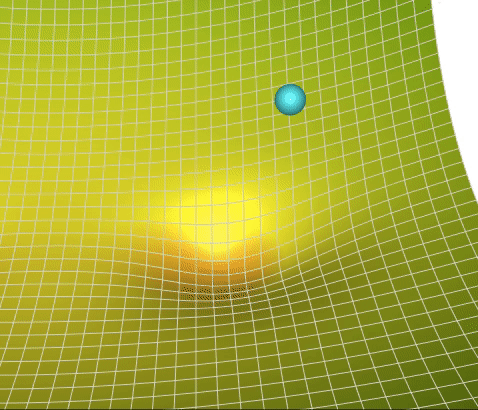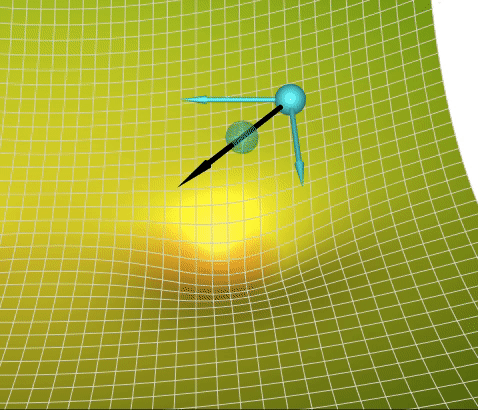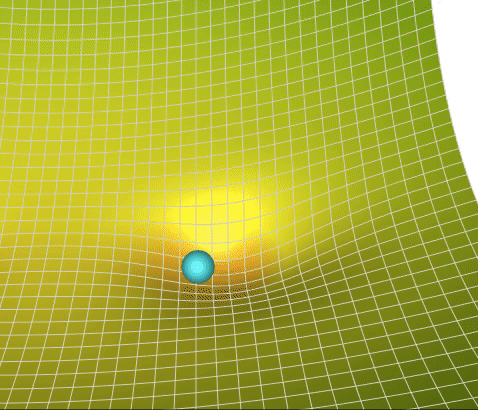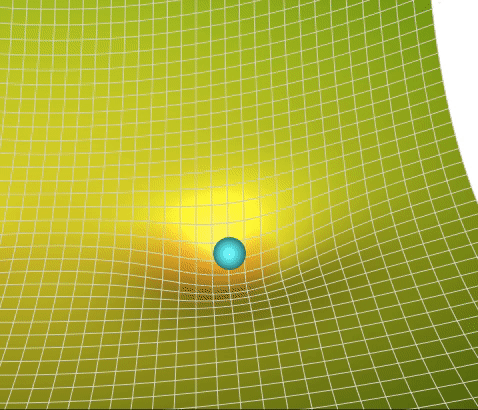
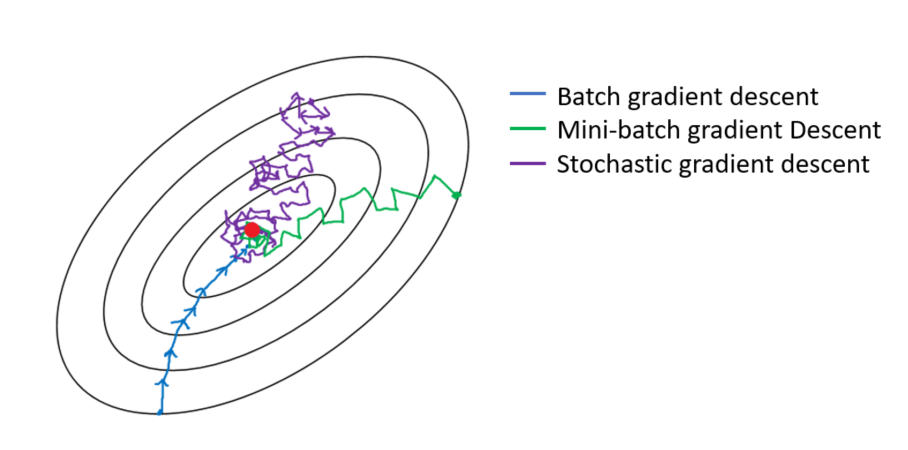
เงื่อนไขหนึ่งที่สำคัญเพื่อให้ได้ gradient ที่ถูกต้องและครบถ้วน คือ gradient ที่ได้ ต้องคำนวนจากข้อมูลๆทุกๆชิ้นมาเฉลี่ยรวมกัน แล้วจึงอัพเดตโมเดลหนึ่งครั้ง เรียกเทคนิคนี้ว่า Batch gradient descent
ปัญหาที่เกิดขึ้นตามมา ในกรณีที่มีข้อมูลจำนวนมากๆๆๆ คือ ในขณะที่เทรน มักไม่สามารถนำข้อมูลทั้งหมดยัดลงใน RAM เพื่อคำนวน gradient พร้อมๆกันได้ทั้งหมดทีเดียว จำเป็นต้องคำนวนแค่เพียงบางส่วนก่อน จากนั้นบันทึก gradient ที่ได้ และทำแบบนี้จนครบทุกๆข้อมูล กระบวนการโหลดข้อมูลบ่อยๆจาก Disk ในกระบวนการที่เสียเวลาอย่างมาก จึงทำให้เกิดอีกแนวคิดหนึ่งเพื่อ speed up กระบวนการเทรนโมเดล คือ Stochastic gradient descent โดยให้โมเดลอัพเดต โดยใช้ gradient จากข้อมูลแค่ 1 ก้อน ไม่ต้องใช้ทั้ง dataset อีกต่อไป
เทคนิคที่ว่านี้ช่วยเร่งความเร็วของการเทรนได้อย่างมาก แต่ทว่า gradient ที่ได้ ไม่ได้เป็น gradient ที่ครบถ้วนอย่างแท้จริง ถึงแม้ว่าในภาพรวมจะไต่ลงไปยังจุดที่มี Loss ต่ำที่สุดเหมือนกัน แต่ การไต่เขาแบบ stochastic เป็นการไต่ไปในทิศทางที่สะเปะสะปะมากกว่ามาก และ หลายๆครั้งอาจจะทำให้ไปไม่ถึงจุดต่ำสุดที่ควรจะเป็น
ทั้งนี้ทำให้เกิดแนวคิดประนีประนอมระหว่า batch และ stochastic โดยไม่ใช้ทั้ง dataset อย่างใน batch และไม่ได้ใช้แค่ข้อมูล 1 ก้อนอย่างใน stochastic แต่ใช้ ข้อมูลเป็น N ก้อน เรียกว่า mini-batch หรือ เรียกเทคนิคนี้ว่า mini-batch gradient descent โดยขนาด mini-batch เป็นสิ่งที่สามารถปรับจูนได้ตามต้องการ โดยมักพิจารณาจากขนาด GPU RAM ที่มี ยิ่งใช้ batch ขนาดใหญ่ ยิ่งจะทำให้การสะเปะสะปะลดลง ส่งผลให้ได้โมเดลที่ดีมากขึ้น แต่ก็ต้องลงทุนกับ GPU มากขึ้นเช่นกัน
ตัวอย่างการ minimize loss โดยใช้ gradient descent แบบต่างๆ โดยจะมี จุดสีแดง เป็นเป้าหมายของ optimizer
Note
- ถึงแม้ว่า การไต่ไปตามความชัน หรือ gradient descent สามารถพาไปยังจุดที่ต่ำที่สุดได้ แต่จุดต่ำที่สุดที่ว่า ไม่ได้การันตีว่าจะต้องเป็น จุดที่ต่ำที่สุดจริงๆ (absolute minimum หรือ global minimum) หลายๆครั้ง มันจะได้เป็นจุดต่ำสุดสัมพัทธ์ (relative minimum หรือ local minimum) ซึ่งเป็นจุดที่ต่ำมากๆ เมื่อเทียบกับจุดรอบๆ แต่ไม่ได้ต่ำที่สุด เมื่อพิจารณาทั้งกราฟ
- อีกหนึ่งคำที่มักเจอคู่กับ gradient descent คือ backpropagation ทั้ง 2 มักใช้งานร่วมกันในการเทรนโมเดล โดย backpropagation ใช้ในการคำนวนหา gradient ตามที่ต้องการใช้ในสมการของ gradient descent แต่ gradient descent คือ วิธีการอัพเดตโมเดล เพื่อให้ได้โมเดลที่เก่งขึ้น (minimize a loss function)
Learning Rate
เมื่อย้อนกลับไปดูสมการ Gradeint descent อีกครั้ง ตัวแปรสำคัญอีกตัวที่ยังไม่ได้อธิบายก่อนหน้านี้ คือ α หรือ Learning rate
Learning rate เป็น hyperparameter ที่ใช้ในการกำหนดขนาดของการไต่เขา (ใช้ gradient เพื่อกำหนดทิศทาง) จากการทดลองพบว่า Learning rate เป็นส่วนสำคัญอันดับต้นๆในการเทรน โดย
- ยิ่ง learning rate มากๆ ยิ่งช่วยทำให้โมเดลไต่ไปยังเป้าหมายได้เร็วขึ้น
- แต่ถ้า learning rate มากเกินไป ทำให้การไต่เขาของโมเดล กระโดดไปกระโดดมา ในบางครั้งอาจจะทำให้หลุดโลกไปจากเป้าหมายที่ต้องการ (causes the loss to “bounce around” and even diverge from the minima)
- ถ้า learning rate น้อยเกินไป ทำให้การไต่เขาของโมเดลเป็นไปช้ามาก จนอาจจะไม่ถึงเป้าหมายที่ต้องการในเวลาที่กำหนด
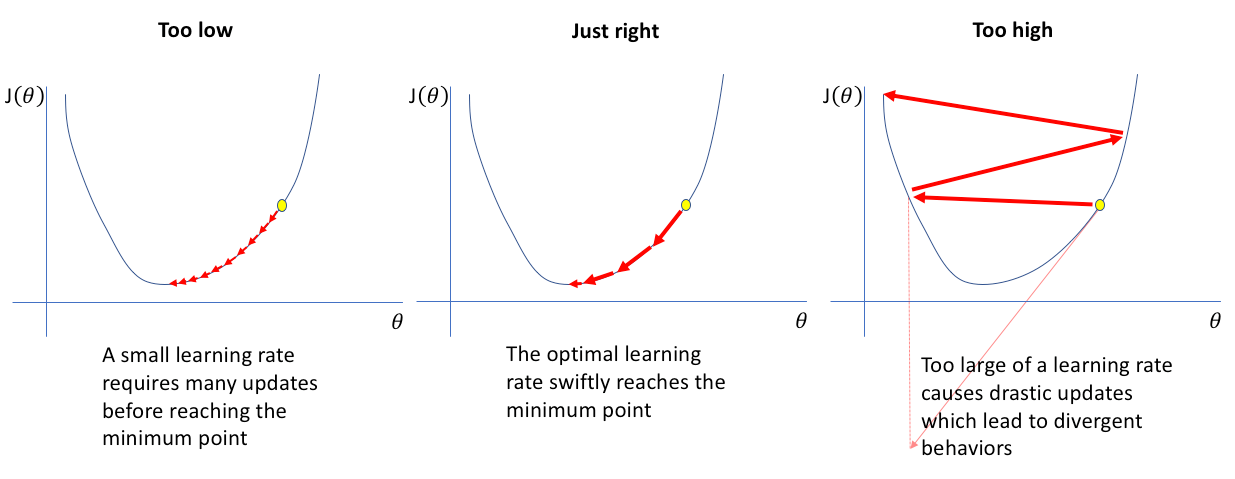
ดังนั้น การปรับจูน learning rate จึงเป็นขั้นตอนสำคัญในการเทรนโมเดล ทั้งนี้ learning rate ที่เหมาะสม ขึ้นอยู่กับทั้ง loss function , โมเดล และ ข้อมูลที่ใช้สอน จึงเป็นไปได้อยากที่จะมีค่าใดค่าหนึ่งที่สามารถใช้ได้อย่างเหมาะสมกับทุกๆกรณี แต่โดยทั่วไปแล้ว learning rate จะตั้งอยู่ที่ประมาณ 0.1–0.01
อีกเทคนิคหนึ่งที่ค่อยๆกลายมาเป็นกระบวนการมาตรฐานในการเทรนโมเดล คือ Learning rate scheduling โดยมีที่มาจากปัญหาว่า learning rate เป็นส่วนสำคัญในการเทรนโมเดล แต่ในแต่ละช่วงของการสอนโมเดลต้องการรูปแบบการเรียนรู้ไม่เหมือนกัน โดยช่วงแรกโมเดลต้องการเรียนรู้แบบกว้างๆ เพื่อเข้าใจภาพรวมของ loss function แต่ในช่วงท้ายๆโมเดลต้องการเรียนรู้แบบละเอียดๆ เพื่อเก็บรายละเอียด ดังนั้น Learning rate จึงไม่ควรเป็นเพียงแค่ค่าคงที่ตลอดการเทรน
โดย Learning rate scheduling มักจะกำหนดให้ learning rate ในช่วงแรกๆมีค่าค่อยๆเพิ่มขึ้น เรียกว่า warmup phase จากนั้นจึงค่อยๆลดลง เรียกว่า relaxing phase ทั้งนี้อัตราการเพิ่ม-ลด สามารปรับเปลี่ยนตามต้องการ แต่ทั่วไปมักให้ warmup ด้วย linear function จากนั้น relaxing ด้วย linear decay หรือ exponential decay
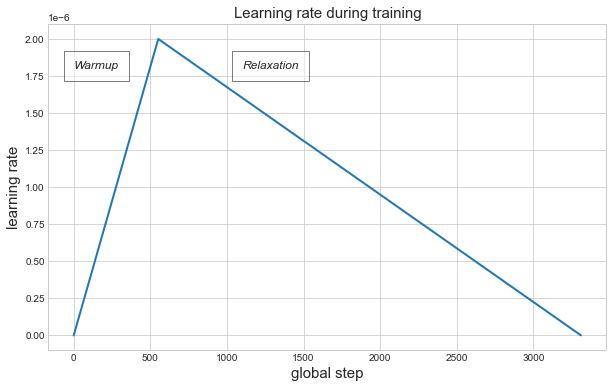
นอกจากนี้แล้วยังมีรูปแบบการใช้ Learning rate scheduling แบบอื่นๆ เช่น Cyclical learning rates ซึ่งใช้ learning rate มีค่าขึ้นๆลงๆตาม sin function [เพิ่มเติม]
Momentum
การเพิ่มโมเมนตัม เป็น อีกเทคนิคหนึ่งซึ่งสามารถช่วยเร่งระยะเวลาที่ต้องใช้เทรนโมเดล โดยในมุมมองทางฟิสิกส์ โมเมนตัม คือ การคงสภาพความเร็วเดิมไว้ระยะหนึ่ง ถึงแม้ว่าจะมีแรงใหม่มากระทำเพื่อเปลี่ยนแปลงความเร็ว หรือ ก็คือ ขณะที่มีการเคลื่อนที่ในทิศทางใดทิศทางหนึ่ง เมื่อมีการเปลี่ยนแปลงเกิดขึ้น จะไม่เปลี่ยนแปลงไปทิศทางใหม่ทันที แต่จะค่อยๆเปลี่ยนไป หรือ ถ้ามีการเคลื่อนที่ไปทิศทางเดิมซ้ำๆ ก็จะมีการสะสมๆ เพื่อทำให้เคลื่อนที่ไปทิศทางเดิมเร็วยิ่งขึ้น
ถ้าพูดให้เห็นภาพ คือ
สมมติให้มีลูกแก้วลูกหนึ่งกำลังไหลลงหลุม ขณะที่ลูกแก้วอยู่ที่ขอบหลุม ลูกแก้วมีความเร็วระดับหนึ่งซึ่งจะค่อยๆพาให้ลูกแก้วไหลไปยังก้นหลุม แต่เมื่อถึงก้นหลุมแล้ว ลูกแก้วที่ควรจะหยุดที่ก้นหลุมทันที แต่เพราะว่ามันยังคงมีความเร็วอยู่ทำให้มันพุ่งขึ้นไปอีกด้านของหลุม แล้วจึงไหลกลับมาที่ก้นหลุมอีกครั้ง หรือ อาจจะทะลุไปหลุมอื่นๆที่อยู่ใกล้กัน
อีกหนึ่งตัวอย่าง คือ
สมมติให้มีลูกแก้วลูกหนึ่งกำลังไหลลงที่ลาดไม่ชันมากอันหนึ่ง ในช่วงแรกๆของการไหล ลูกแก้วมีความเร็วระดับหนึ่ง แต่พอไหลไปเรื่อยๆ ความเร็วของลูกแก้วก็จะเพิ่มขึ้นเรื่อยๆ ทำให้ลูกแก้วสามารถไปถึงจุดที่อยู่ด้านล่างสุดได้เร็วกว่าเดิม
ตัวอย่างทั้ง 2 เป็นการคงสภาพความเร็วของลูกแก้ว หรือ Momentum ของลูกแก้วในแบบต่างๆ
โดยในกรณีแรก มักใช้เปรียบเทียบในกรณีที่ Loss surface มี local minimun อยู่ การใช้ momentum สามารถผลักให้ model หลุดจากจุดเดิมไปยังจุดใหม่ที่(อาจจะ)เป็น minimum ที่ต่ำกว่า
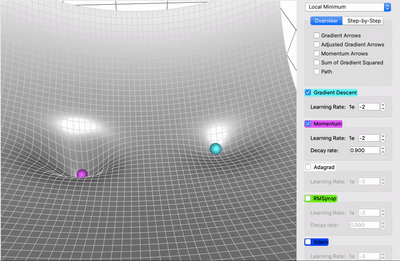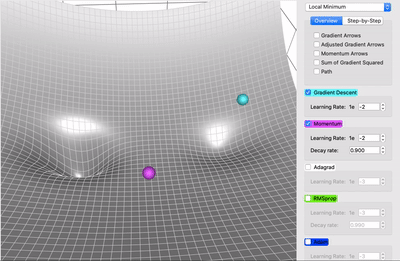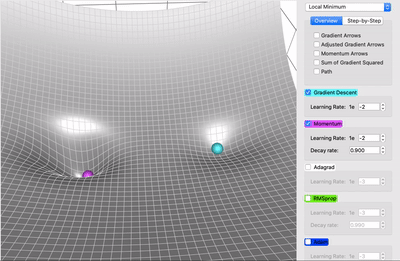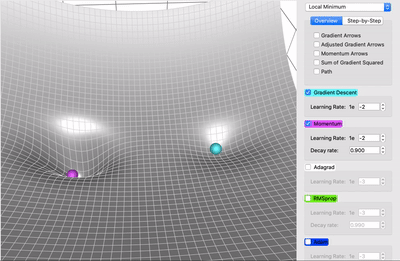
ทั้งนี้ การใช้ Momentum เพื่อแก้ปัญหา local minimum ยังมีการถกเถียงอยู่พอสมควร เพราะว่า จุด minimum ใหม่ที่เจอ ไม่ได้การันตีว่าจะเป็น minimum ที่ดีกว่าจุดเดิม การใช้ momentum อาจจะทำให้พุ่งไปเจอจุดที่แย่กว่าเดิม
สำหรับในกรณีที่ 2 เป็นตัวอย่างการใช้ momentum เพื่อเร่งความเร็วในการหา minimum โดยเฉพาะเมื่อง loss surface มีลักษณะที่เป็น Plateau (ที่ราบ) หรือ Ravine (หุบเขาลึก)
โดยในกรณีที่เป็น Plateau เนื่องจาก loss บริเวรณนี้เท่าๆกันหมด มีการเปลี่ยนแปลงน้อย ทำให้ gradient น้อยตามไปด้วย ดังนั้น การอัพเดตแต่ละครั้ง จึงเป็นเพียงแค่ก้าวเล็กๆ ต้องอัพเดตหลายๆรอบถึงจะผ่านที่ราบไปได้ โดย momemtum ทำให้เกิดการสะสมของ gradient เพราะว่ามีการไหลไปทิศเดิมๆซ้ำๆ ทำให้ทะลุผ่าน plateau ไปได้เร็วขึ้น
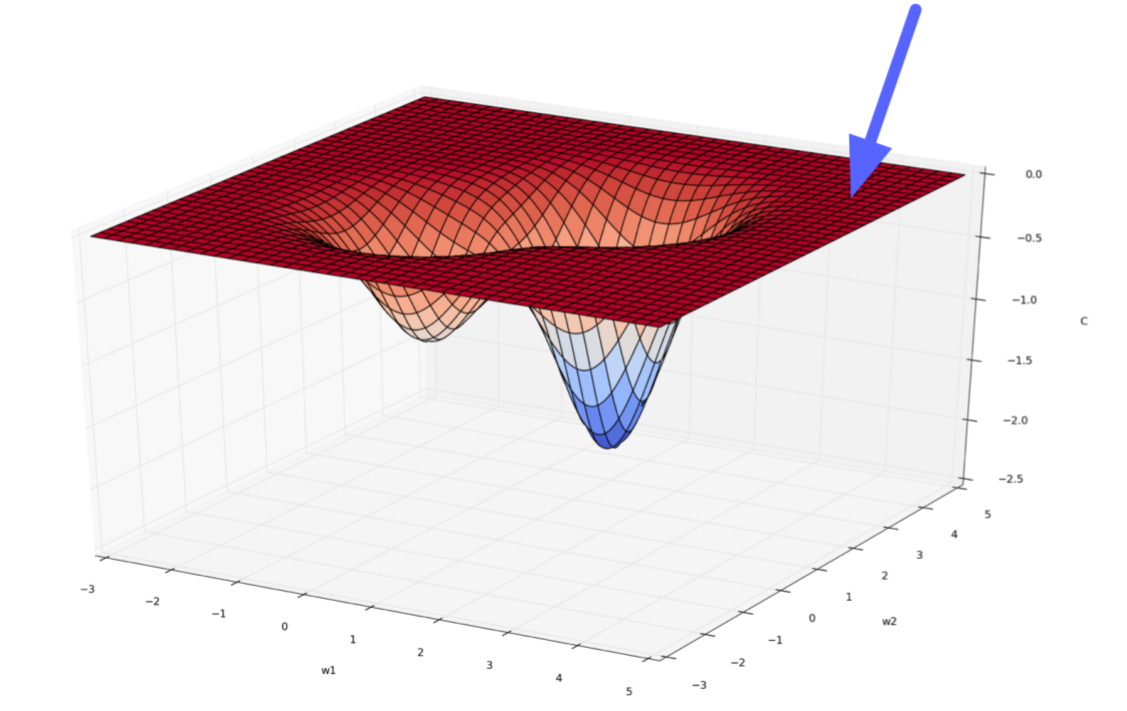
Loss surface with Plateau http://www.cs.toronto.edu/~rgrosse/courses/csc321_2017/slides/lec7.pdf
ในกรณีของ Ravine หรือ หุบเขา ซึ่งมีจุดที่ loss มากๆ ขนาบด้วย ทางแคบๆที่มี loss น้อยๆ แต่ทางแคบๆนั้น ค่อยๆลาดลงไปยังก้นเหว
สิ่งที่มักเกิดขึ้นกับ gradient descent คือ โมเดลไต่ไปในรูปแบบซิกแซกไปมาๆ เพราะว่า ขณะที่โมเดลอยู่ที่เนินฝั่งซ้าย gradient ชี้ให้อัพเดตไปทางแคบที่อยู่ตรงกลาง ซึ่งอยู่ทางขวา แต่เนื่องจากตรงกลางเป็นทางแคบๆ ทำให้อัพเดตพุ่งไปเนินฝั่งขวา ต่อมาด้วยเหตุผลเดียวกัน รอบต่อมา โมเดลก็จะสลับกลับมาที่ฝั่งซ้าย สลับไปสลับมา ทั้งๆที่มันควรจะไต่ลงด้านล่าง ตามทางแคบๆ เพื่อไปยังจุดที่ดีที่สุด
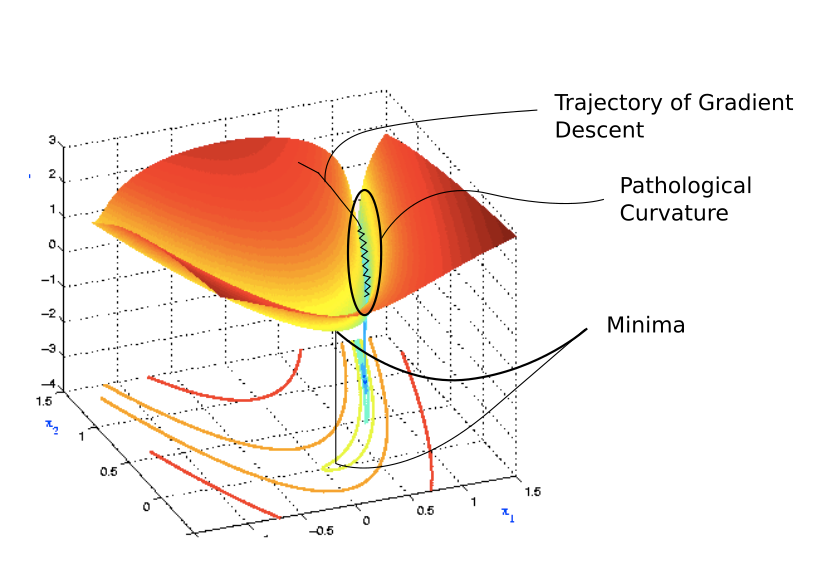
Loss surface with Ravine http://www.cs.toronto.edu/~rgrosse/courses/csc321_2017/slides/lec7.pdf
ในกรณีนี้ ขณะที่ gradient descent อัพเดตซิกแซกไปมาๆ แต่การซิกแซกนี้ ในความเป็นจริงแล้วจะลาดลงเล็กๆ โดย momentum สามารถช่วยเสริมขนาดของทิศการลาดลงไปด้านล่างนี้ เพราะว่า ไม่ว่าจะซิกแซกไปทางซ้าย หรือ ขวา ก็จะมีลาดลงไปทางเดียวกัน ทำให้ momentum ในการลาดไปด้านล่างมีขนาดเพิ่มขึ้น และพาโมเดลพุ่งไปถึงก้นเหวได้เร็วกว่าเดิม
ต่อมา ขอพูดถึงในรูปแบบของสมการกันบ้าง
ตามนิยามที่อธิบายไปแล้ว ว่า momentum คือ การคงสภาพความเร็วเดิม ซึ่งความเร็วในที่นี้ คือ gradient ที่จะอัพเดตในแต่ละรอบ ดังนั้น momentum จึงสามารถเขียนเป็นสมการได้ดังนี้
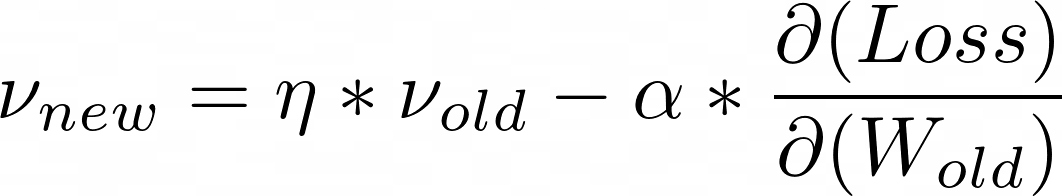
อธิบายในเป็นข้อความ คือ สิ่งที่จะอัพเดตในรอบนี้ v_new คือ ส่วนหนึ่งของการอัพเดตครั้งก่อน (η * v_old) บวกกับ gradient ของรอบนี้ (-α * dL/dw)
โดย η คือ momentum factor ซึ่งมีค่าระหว่าง 0 ถึง 1
จากนั้น การอัพเดต parameter จึงเป็นไปตามสมการนี้
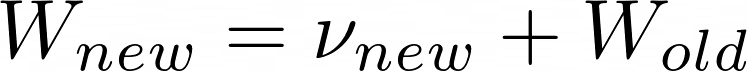
Regularization
เป็นอีกหนึ่ง term ที่มักพบเมื่อมีการใช้ optimizer ซึ่งทำหน้าที่จำกัดไม่ให้โมเดลยึดติดกับข้อมูลที่ใช้เทรนมากเกินไป ซึ่งมักทำให้โมเดลไม่สามารถทำนายข้อมูลแปลกๆที่ไม่เคยเจอมาก่อนได้
โดยทั่วไปแล้ว regularization สามารถทำได้โดยการเพิ่ม term เข้าไปใน loss function เพิ่มกำหนดลักษณะบางอย่างของโมเดล หากฝ่าฝืน จะทำให้ loss ในส่วน regularization เพิ่มขึ้น เช่น L2 regularization ซึ่งจะลงโทษ เมื่อโมเดลพยายามใช้ parameter ที่มีค่าเยอะๆ
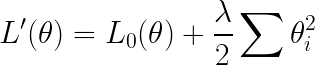
ซึ่งเมื่อใช้ L2 regularization แล้ว จำเป็นต้องเปลี่ยนสมการการปรับ parameters ดังนี้
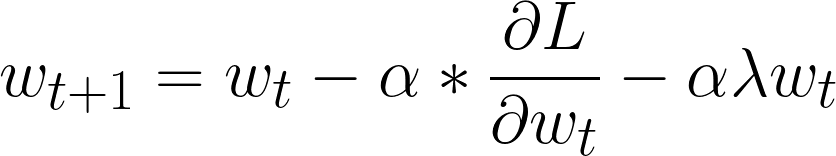
ซึ่ง term ใหม่ที่เพิ่มเข้ามานี้มักโดนเรียกว่า weight decay เพราะว่า มันทำหน้าที่ ลบ wt ออกไป ตาม decay rate λ
แต่อย่างไรก็ตาม สามารถมองได้ว่า regularization เป็นเพียงแค่ส่วนหนึ่งของ loss function โดยไม่ได้กระทบกับการทำงานของ optimizer :)
//ทำงานแบบเดิม เพิ่มเติม คือ สมการเยอะขึ้น
Advanced Optimizers
ต่อมา จะมาพูดถึง optimizers แบบซับซ้อนกันบ้าง ซึ่งมีเป้าหมายเหมือนกัน คือ ช่วยเร่งให้โมเดลยิ่งเก่งขึ้นในระยะเวลาที่ลดลง
โดยทั่วไปแล้ว advanced optimizers เป็นการต่อยอด gradient descent ไม่ว่าจะเป็น [เพิ่มเติม]
- เปลี่ยนทิศทางในอัพเดตในรอบต่อไป (gradient term)
- เปลี่ยนขนาดในอัพเดตในรอบต่อไป (learning rate term)
- เปลี่ยนทั่งคู่เลย
Nesterov Accelerated Gradients (NAG)
NAG เป็นเทคนิคที่เพิ่มเติมจาก momentum โดยเมื่อเปรียบเทียบกับลูกแก้วที่มี momentum ในตัวอย่างก่อนๆ NAG เป็นเสมือนการเปลี่ยนลูกแก้วธรรมดาเป็นลูกแก้ววิเศษที่สามารถรู้อนาคตของตัวเองได้
โดยถ้าลูกแก้วรู้ว่า ในรอบต่อไปมันจะเจอกับทางลาดขึ้น ซึ่งจะทำให้มันต้องไหลย้อนกลับมาทางเดิมอีกครั้ง ลูกแก้วก็จะชิงลดความเร็วลงไปก่อนเลย เพื่อจะไม่ต้องเสียเวลากลิ้งไปมาๆ
โดยใช้สมการ momentum เดิม
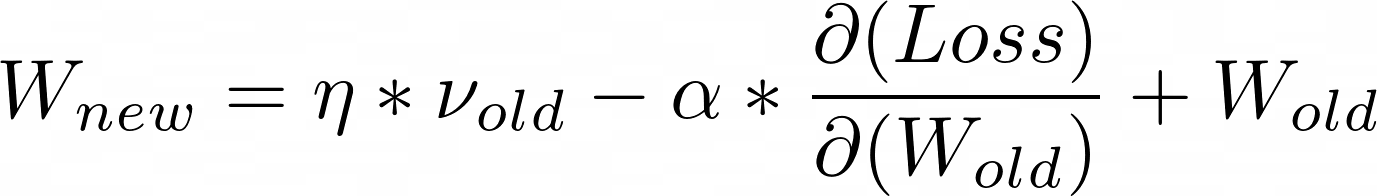
Gradient update with momentum term
NAG ประมาณค่า parameter ต่างๆในอนาคต ตามสมการด้านล่าง โดยลบ gradient term โดยใช้สมมติฐานว่า gradient term เป็นแค่เลขน้อยๆ เมื่อเทียบกับ term อื่นๆ
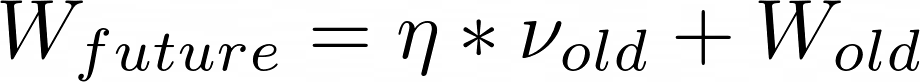
จากนั้น จึงแทนสมการคำนวน สิ่งที่จะอัพเดต เป็น สิ่งที่จะอัพเดตในรอบนี้ v_new คือ ส่วนหนึ่งของการอัพเดตครั้งก่อน (η * v_old) บวกกับ gradient ที่จะเกิดขึ้นในอนาคต (-α * dL/dw_future)
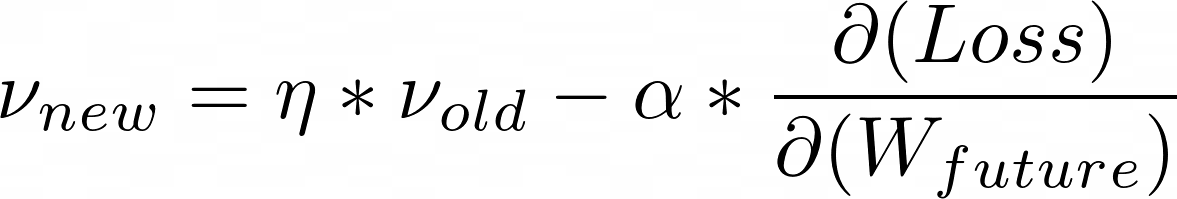
Adaptive Optimizers
อีกหนึ่งข้อสังเกตที่เกิดขึ้นหลัง นักวิจัยศึกษา Gradient descent มาระยะหนึ่ง คือ จริงๆแล้ว learning rate และ momentum ไม่ควรเป็นค่าที่ใช้ร่วมกับสำหรับทุกๆ parameters เพราะ parameters แต่ละตัว ต่างทำหน้าที่แตกต่างกัน parameters ที่อยู่ใน neural network ชั้นแรกๆ ทำหน้าที่จัดการความหมายระดับคำ แต่ ชั้นหลังๆ ทำหน้าที่จัดการความหมายโดยรวม — ตัวอย่างนี้ อาจจะไม่ตรงตามความเป็นจริง ยกขึ้นมาเพื่อให้เห็นภาพตรงกัน
ทำให้เกิดแนวคิดที่เป็น Adaptive optimizers ซึ่งจะให้ learning rate และ momentum ของ parameters แต่ละตัวไม่เท่ากัน บางคนต้องการเปลี่ยนแปลงอย่างรวดเร็ว ก็จะมี learning rate มากๆ แต่บางตัวไม่ ก็จะมี learning rate น้อยๆ
Adagrad
Adagrad เป็นแนวคิดแรกๆของการทำ adaptive optimization โดยนิยามตัวแปรขึ้นมาอีกหนึ่งตัว เรียกว่า cache ซึ่งเป็นผลรวมของ gradients ของ parameters
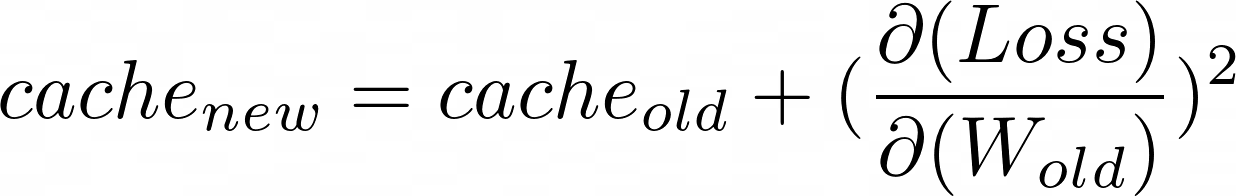
โดย cache ของแต่ละ parameter จะเก็บแยกกัน ถ้าโมเดลมี parameters 10 ตัว ก็จะมี caches 10 ค่า ใช้สำหรับ parameters แต่ละตัว
ซึ่ง cache นี้เป็นลดบทบาทของ learning rate โดย
- ขณะที่ parameters wi อัพเดตไปแล้วเยอะๆ จะทำให้ learning rate ของ wi มีค่าน้อยๆ ในรอบต่อๆไป wi จะโดยอัพเดตน้อยลง
- ขณะที่ parameters wj ไม่เคยโดยอัพเดตเลย cache จะช่วยเพิ่ม learning rate ของ wj ให้มีค่ามากขึ้น ในรอบต่อๆไป wj จะโดยอัพเดตเยอะขึ้น
โดยการอัพเดต จะเป็นไปตามสมการต่อไปนี้
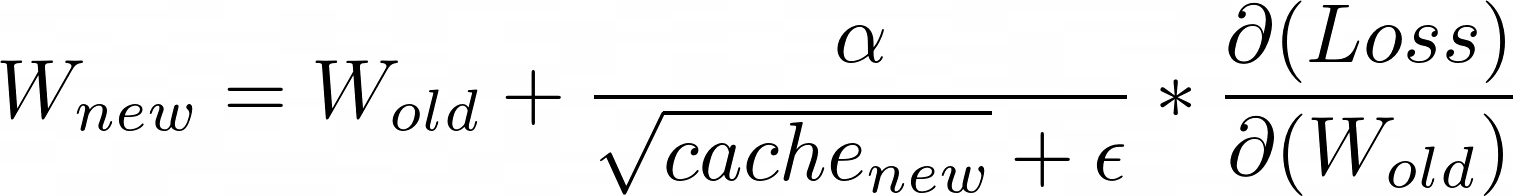
ค่าที่อยู่ใน cache ใช้เป็นการปรับจูน learning rate ตามที่อธิบายไปแล้ว โดยใส่รูท เพื่อทำให้ cache อยู่ในหน่วยเดียวกับ α (เดิม cache มีหน่วยเป็น α² เพราะว่า เป็นผลรวมของ gradient² )และ e เป็นตัวเลขเล็กๆ ใช้เพื่อป้องกันไม่ให้เกิดเหตุการณ์ที่เศษส่วนเป็น 0 ซึ่งโดยปกติแล้ว จะให้ e = 1e-8
ทั้งนี้ เนื่องด้วย cache เป็นผลรวมของ gradient² ซึ่งจะมีค่าเพิ่มขึ้นเสมอ เพราะว่าค่ายกกำลังสองเป็นบวกเสมอ จึงพูดได้ว่า cache จะมีค่าเพิ่มขึ้นเรื่อยๆอย่างรวดเร็ว ส่งผลให้ learning rate จะลดลงอย่างรวดเร็ว ซึ่งบางครั้ง learning rate ลดลงเร็วเกินไปจนทำให้ parameters บางตัว ไม่เปลี่ยนแปลงอีกต่อไป (learning rate ≈0) ในขณะที่ยังไม่สิ้นสุดการเทรน
RMSProp
RMSProp พยายามแก้ปัญหาของ Adagrad ด้วยการแทนที่ cache ด้วยการใช้ exponential average ตามสมการ โดยมี γ เป็น hyperparameter กำหนด decay rate ซึ่งจะลดทอนความสำคัญของ gradient² ในรอบก่อนๆ โดยปกติแล้ว กำหนดให้ γ อยู่ที่ 0.9 ถึง 0.99
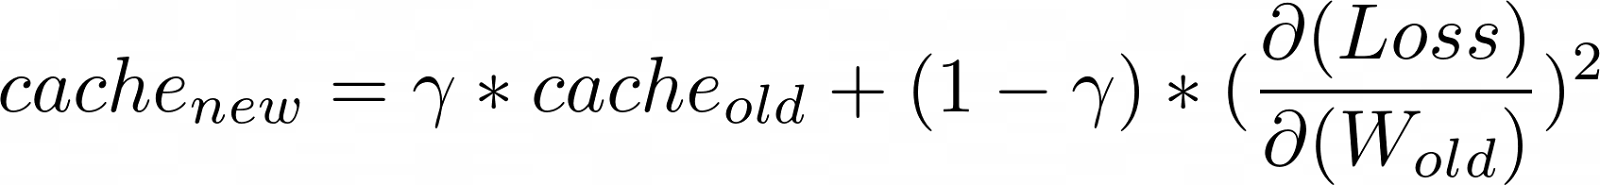
ตามตัวอย่างด้านล่าง จะพบว่า ยิ่งเวลาผ่านไป จะยิ่งทำให้ gradient² ในรอบก่อนๆมีค่อยๆมีค่าความสำคัญลดลง หรือ พูดอีกแง่ คือ cache เน้นสนใจเฉพาะ gradient² จากรอบที่อยู่ไม่ห่างจากรอบปัจจุบัน ซึ่งนี้ทำให้อัตราการเพิ่มขึ้นของ cache ช้าลงกว่าเดิม
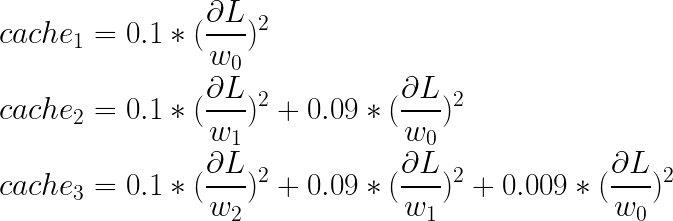
แจกแจงการคำนวน cache โดยให้ γ = 0.9 และแทน w_t ด้วย parameter w ในรอบที่ t
Adam
Adam เป็นเทคนิคที่พูดได้ว่า popular ที่สุดในปัจจุบัน ซึ่งรวมเอาข้อดีจากทั้ง RMSProp และ momentum เข้าไว้ด้วยกัน โดยใช้รวมเอาไว้ด้วยกันซะเลย
สมการแรก ใช้คำนวน momentum
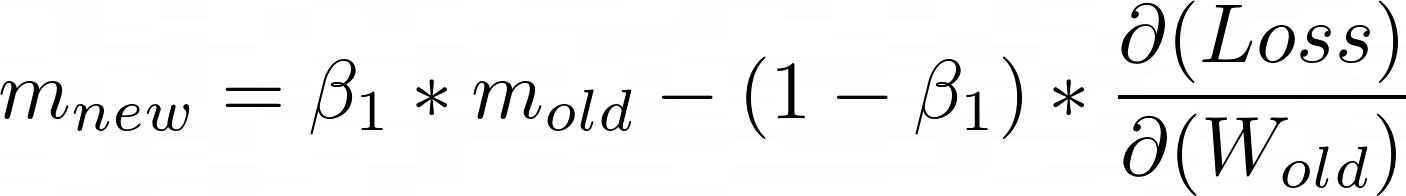
สมการที่ 2 ใช้คำนวน cache ที่จะใช้ในการปรับ learning rate
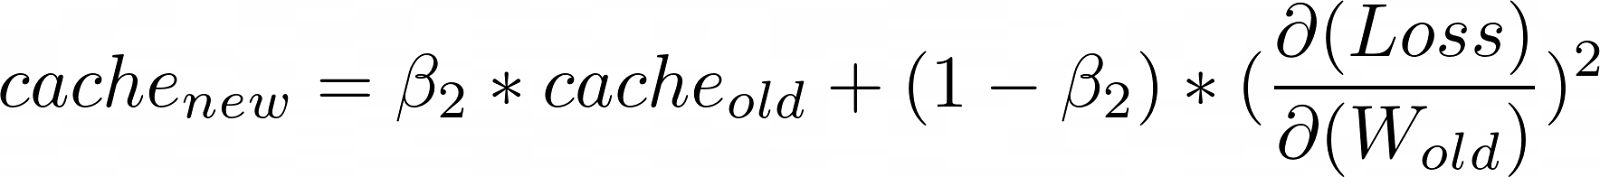
โดย β1 และ β2 มักจะกำหนดอยู่ที่ 0.9 และ 0.99 ตามลำดับ —ปกติก็ใช้ค่า default นี้เลย
แต่จากการวิเคราะห์ พบว่า ทั้ง momemtum term และ cache term ที่คำนวนด้วยวิธีนี้มี bias เล็กๆ ที่เกิดจากว่า m0 และ cache0 ที่เป็นค่าเริ่มต้น กำหนดให้เป็น 0 ทำให้มีอาการเพี้ยนๆในระยะแรก ทั้ง 2 term จำเป็นจะถูกนำแก้ bias ก่อน ตามสมการ
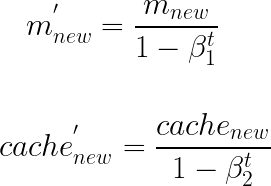
เพราะว่าเป็น exponential average จึงแก้ bias ด้วยการหารด้วย 1 — (β1 และ β2 ยกกำลัง t)
จากนั้นก็เอาแทนในสมการของ RMSProp เดิม โดยใช้ m และ cache ที่แก้ bias แล้ว
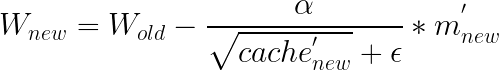
แต่ที่น่าสนใจคือ ในหลายๆครั้ง Adam ที่ดูเหมือนว่า สามารถเอาจุดเด่นของๆทุกๆ optimizers มาใช้ประโยชน์ได้อย่างมีประสิทธิภาพ แต่กลับทำงานได้แย่กว่า SGD with momentum ในบางกรณี
จึงมีความพยายามในการพัฒนา Adam ออกมาในหลากหลายรูปแบบ เช่น AdaMax ที่แทนสมการ cache โดยการใช้ ℓ-∞ converges ซึ่งออกมาในรูปของ max(…) หรือ NAdam ซึ่งรวม NAG เข้ากับ Adam หรือ AdamW ที่เป็นการเอา Adam มารวมกับ weight decay [เพิ่มเติม] แต่อย่างไรก็ตาม SGD with momentum และ Adam ก็ยังเป็น optimizer มาตรฐานที่ใช้กันทั่วๆไป
แต่อย่างไรก็ตาม ช่วง 2–3 ปีที่ผ่านมานี้ มี optimizers ตัวใหม่ๆออกมาเรื่อยๆ แต่ทั้งนี้ คงต้องใช้เวลาเป็นเครื่องพิสูจน์ ว่าความสามารถของแต่ละตัวจะรอดความเกรี้ยวกราดในทะเลแห่งวงการ Deep learning ไปได้แค่ไหน
DiffGrad
เป็น optimizer ตัวใหม่ (2019) ซึ่งต่อยอดจาก Adam โดยเพิ่มเบรกให้ Adam เพื่อให้มันไม่หลุดไปจาก global minimum —ไว้เขียนเพิ่มเติม ถ้ามีโอกาส[เพิ่มเติม]
Ranger
เป็น optimizer ตัวใหม่อีกตัว (2019) [เพิ่มเติม] ซึ่งต่อยอดจาก Adam เช่นกัน โดนประกอบจาก 2 เทคนิค มารวมกัน คือ
1) RAdam ซึ่งเกิดจากปัญหาที่ว่า ในช่วงแรกๆของการเทรนโมเดล ขณะนั้น โมเดลยังเห็นข้อมูลไม่มากพอ ทำให้มีแนวโน้มว่าโมเดลจะเพี้ยนไป overfitting กับรูปแบบข้อมูลบ้างส่วน ซึ่งส่งผลระยะยาว ทำให้โมเดลหลุดไปอยู่ที่ local minimum ที่ไม่ได้เป็น global minimum ที่แท้จริง โดยทั่วไปแล้ว ปัญหานี้สามารถแก้ด้วยการใช้ learning rate scheduling ที่มี warm-up phase ซึ่งจะให้โมเดลเรียนรู้ด้วย learning rate น้อยๆในช่วงแรกๆ เพื่อป้องกันไม่ให้โมเดลมั่นอกมั่นใจไปกับตัวอย่างใดตัวอย่างหนึ่งจนเกินไป และค่อยๆเพิ่ม learning rate ทีละน้อยๆ ให้โมเดลปรับตัว
โดน RAdam ออกแบบมาเพื่อแทนที่ warm-up phase ที่ว่านี้ด้วยสมการยุบยับบางอย่าง :)
2) Lookahead เป็นเทคนิคใหม่ ที่ช่วยเพิ่มความเสถียรให้กับโมเดล โดยการสร้างโมเดลเพิ่มอีก 1 ตัว เรียกว่า “fast weights” และใช้โมเดลใหม่ที่ว่านี้เป็นตัวช่วยในการชี้นำทิศทางในการอัพเดต parameters โดยเริ่มต้นจากการให้โมเดล fast weights นี้ก๊อปปี้ parameters จากโมเดลตั้งต้น จากนั้นก็เทรนด้วย optimizers อะไรก็ได้ K รอบ จากนั้นจึงอัพเดตโมเดลตั้งต้น โดยใช้ทิศทางที่ชี้ไปยังจุดสุดท้ายที่ fast weights อยู่
เทคนิคนี้เป็นเทคนิคที่เรียบง่าย ไม่ต่างจากการให้ตัวแทนเดินไปก่อน เพื่อสำรวจทาง จากนั้นจึงค่อยเดินตามไปด้วยทิศทางสุดท้ายที่โมเดลตัวแทนยืนอยู่ — ใช้ผลการสำรวจเป็นแค่เครื่องนำทาง โดยโมเดลต้นทาง อัพเดตแค่ก้าวสั้นๆ ไม่ได้ก้าวไปยืนที่เดียวกับโมเดลตัวแทน [เพิ่มเติม]
ในที่สุดก็มาถึงจุดพักระหว่างทางอีกจุดหนึ่งของการเรียนรู้ Deep learning ยังมีงานวิจัยใหม่ๆหลั่งไหลเข้ามาอยู่ตลอดเวลา เทคนิคใหม่ๆที่ช่วยทำให้โมเดลเก่งขึ้น เรียนรู้ไวขึ้น ทำงานกับโจทย์ท้าทายใหม่ๆ
จนกว่าจะมี AGI หรือ ซอมบี้ครองโลก เราทุกคนก็ยังต้องพัฒนาตัวเองกันต่อไป สู้ๆครับ :)
Credit
บทความนี้ ต้องขอขอบคุณ
- An overview of gradient descent optimization algorithms บทความจาก Sebastian Ruder ซึ่งอธิบาย optimizer แบบต่างๆอย่างง่ายๆ และ ชัดเจน
- Understanding Optimizers ซึ่งผู้เขียนใช้เป็นแหล่งที่มาของสมการต่างๆในบล๊อคนี้ ขอขอบคุณมา ณ ที่นี้
ทั้งนี้ขอขอบคุณผู้อ่านทุกๆคนที่ตามอ่านมาจนถึงตรงนี้ กราบ กราบ กราบ :)