คำเตือนเนื้อหาในบทความนี้เต็มไปด้วยศัพท์แสงทางวิชาการ โปรดใช้วิจารณญาณก่อนเสพ
สวัสดีครับ หลังจากที่ทำความรู้จักกับ Transformer กันไปแล้วในบล๊อคก่อนหน้านี้ ก็มาถึงคราวที่ ผู้เขียนขอชวนทุกๆคน มารู้จักกับโมเดลรุ่นใหม่ๆ อีกตัวหนึ่ง ที่ชื่อ BERT กันบ้าง โดยเนื้อหาทั้งหมดนี้ เป็นเนื้อหากึ่งแปลกึ่งสรุปจากเปเปอร์ BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding จึงขอขอบคุณมา ณ ที่นี้ หากใครสนใจศึกษาเพิ่มเติม สามารถกดไปอ่านตามลิงค์ได้เลยครับ
ทั้งนี้ เนื้อหาในส่วนต่อๆไป มีการอ้างถึงโครงสร้างส่วนต่างๆ ของ Transformer สำหรับใครที่ยังไม่รู้ว่า Transformer ทำงานยังไง? หรือ ยังไม่ทราบรายละเอียดต่างๆ ของกระบวนการ Self-Attention อาจจะสับสนได้ ผู้เขียนขอแนะนำให้ ตามอ่านบทความก่อนหน้านี้ก่อนนะครับ
{ทำความเข้าใจ Transformer Part I, Part II, Part III}
จะว่าไปแล้ว 2–3 ปีที่ผ่านมา ข่าวคราวของ BERT พุ่งขึ้นมาเป็นหนึ่งในหัวข้อยอดฮิตในวงการ NLP ด้วยความสามารถในการจัดการกับปัญหาที่หลากหลาย ไม่ว่าจะเป็น Text Classification, Question Answering, Named Entity Recognition etc และยังสามารถจัดการได้ด้วยความแม่นยำที่เรียกได้ว่า เอาชนะโมเดลอื่นๆไปได้อย่างขาดลอย ในบางปัญหาถือได้ว่าอยู่ในระดับเดียวกับมนุษย์เลยทีเดียว (แต่ปัจจุบันมีหลายๆโมเดล เอาชนะไปได้แล้วด้วยความแม่นยำที่สูงกว่า)
Transfer Learning era in NLP
ทำไม BERT ถึงได้รับความสนใจจากนักวิจัยทาง NLP จำนวนมาก? คำตอบ คือ การมาของ BERT เป็นหนึ่งในจุดเริ่มต้นของการมาถึงของ ImageNet moment สำหรับวงการ NLP
โดย ImageNet monent ที่ว่านี้ คือ เป็นการเปรียบเทียบกับเหตุการ์ณเมื่อราวๆ ปี 2012 ซึ่งนักวิจัย ในวงการ Computer Vision พบว่า Deep Convolutional Neural Networks ประสบความสำเร็จอย่างมากในการแก้ปัญหา Image Classification จากข้อมูล ImageNet และสิ่งที่น่าตื่นเต้นมากไปกว่านั้น คือ การค้นพบว่า โมเดลที่สอนโดยการใช้ข้อมูลจาก ImageNet นี้ สามารถนำไปแก้ปัญหาอื่นๆทาง Computer Vision ได้อีกเป็นจำนวนมาก ด้วยเทคนิคที่เรียกว่า Transfer Learning
เนื่องจาก โดยทั่วไปแล้ว วิธีการมาตรฐานในการสร้างโมเดล machine learning เริ่มต้นจากการรวบรวมข้อมูลจำนวนมากๆ จากนั้นก็นำไปป้อนให้โมเดลค่อยๆเรียนรู้ จนมันสามารถแก้ไขปัญหาที่ต้องการ
ปัญหาที่มักเกิดขึ้น คือ เมื่อเปลี่ยนเป้าหมาย หรือ เปลี่ยนแปลงลักษณะของข้อมูล หรือแม้กระทั้งเปลี่ยนแหล่งที่มาของข้อมูล โมเดลที่เคยสอนไปแล้วมักจะไม่สามารถทำงานได้ดีกับข้อมูลใหม่ที่เกิดขึ้น จึงจำเป็นจะต้องเริ่มต้นสอนโมเดลใหม่ตั้งแต่ต้นทุกครั้งที่มีการเปลี่ยนแปลงเกิดขึ้น นี้เป็นปัญหาที่สร้างความลำบากเป็นอย่างมากในการนำโมเดลไปใช้จริงในเชิงธุรกิจ
โดยเทคนิค Transfer learning ที่กล่าวถึงไปแล้ว คือ ความพยายามในการถ่ายโอนความรู้จากโมเดลขนาดใหญ่ที่โดนเทรนมาแล้วด้วยข้อมูลปริมาณมาก ไปใช้แก้ปัญหาอื่นๆที่ต่างไปจากปัญหาเดิม เช่น เริ่มต้นเทรนเพื่อแก้ปัญหา Image Classification 1000 classes จากนั้นเอาไปเทรนต่อเพื่อทำ Cat-dog Classification เป็นต้น
โดยเทคนิคนี้ เริ่มต้นจากการสร้างโมเดลตัวใหญ่ๆหนึ่งตัว โดยทั่วไปแล้วมักจะสอนมันด้วยข้อมูลที่มีขนาดใหญ่มากๆ โดยใน ImageNet ที่พูดถึงไปแล้ว มีข้อมูลรูปภาพมากถึง ~1.2 ล้านรูป แบ่งเป็นประเภทมากกว่า 1,000 ประเภท
ที่น่าสนใจ คือ ด้วยข้อมูลที่มีขนาดใหญ่เพียงพอ+โมเดลที่สามารถในการจัดการข้อมูลประเภทรูปภาพได้เก่งขึ้นมากๆ ทำให้โมเดลขนาดใหญ่ที่ว่านี้ (หรือเรียกว่า “pre-trained models”) มีความสามารถในการตรวจจับโครงสร้างต่างๆในรูปภาพได้เป็นอย่างดี แม้กระทั้งกับรูปภาพใหม่ที่ไม่เคยรู้จักมาก่อน ด้วยความสามารถนี้ นักวิจัยหลายๆท่านจึงเห็นโอกาสในการนำ pre-trained models เหล่านี้ไปเทรนต่อด้วยข้อมูลใหม่ตามที่ต้องการเพียวเล็กน้อย แล้วพบว่ามันสามารถแก้ไขปัญหาได้อย่างถูกต้อง กระบวนการณ์นี้ช่วยลดเวลาและทรัพยากรที่ต้องใช้ได้อย่างมหาศาล เพราะไม่จำเป็นต้องสอนโมเดลใหม่ตั้งแต่ต้นทุกครั้งที่เปลี่ยนปัญหาแค่เพียงเล็กน้อย จึงกล่าวได้ว่า ImageNet moment นี้เป็นจุดเริ่มต้นที่ทำให้โมเดลต่างๆทาง Computer Vision สามารถนำออกไปใช้จริงๆในเชิงปฎิบัติ ไม่ใช่แค่ในห้องทดลอง
ย้อนกลับมาที่ปัญหาทาง NLP: จากการศึกษางานเก่าๆ จะพบว่า มีการใช้เทคนิคคล้ายๆกันนี้ในงานด้าน NLP มาแล้วตั้งแต่ปี 2013 (หรืออาจจะก่อนหน้านั้น) โดยวิธีมาตรฐานในสมัยนั้น เป็นการประยุกต์ใช้เทคนิค word2vec หรือ GloVe เพื่อแปลงคำต่างๆในเอกสารหรือประโยคที่ต้องการ ไปเป็นเวกเตอร์ก่อน จากนั้นจึงใช้เวกเตอร์ที่ได้นี้ไปใช้ในการเทรนโมเดลเพื่อแก้ปัญหาที่ต้องการต่อไป เนื่องด้วยว่า เวกเตอร์ที่ได้จากเทคนิคเหล่านี้ สามารถแสดงให้เห็นถึงคุณสมบัติบางอย่างทางภาษา เช่น Word Similarity ซึ่งมีแนวโน้มว่าคุณสมบัติเหล่านี้ จะช่วยให้โมเดลเรียนรู้วิธีการแก้ปัญหาใหม่ๆได้ดียิ่งขึ้น
โดยขั้นตอนการเปลี่ยนคำเป็นเวกเตอร์นี้ ในเชิงปฎิบัติ มักเป็นแค่การเทียบคำจากตารางข้อมูลที่มีรายการของคำทั้งหมดที่เป็นไปได้เพื่อค้นหาว่า คำๆนี้ควรเปลี่ยนเป็นเวกเตอร์อะไร (lookup table) ซึ่งตารางที่ว่านี้ เป็นผลลัพท์ที่สร้างจาก word2vec หรือ GloVe โดยการสอนด้วยข้อมูลที่มีขนาดใหญ่ๆ [เพิ่มเติม] จึงถือได้ว่า word2vec และ GloVe เป็น pre-trained model รุ่นแรกๆ ของวงการ NLP
แต่อย่างไรก็ตาม หลายๆงานวิจัยพบว่า โมเดลที่ได้จากเทคนิคนี้ มักไม่ได้ผลลัพธ์ที่ดีเท่าที่ควร ผลลัพท์ที่ได้ไม่ได้แตกต่างจากการสร้างโมเดลที่มีใช้เวกเตอร์แบบอื่นๆมากนัก ถึงแม้ว่าทั้ง word2vec และ GloVe สามารถสร้างเวกเตอร์ที่มีความหมายทั้งในเชิง syntax และ semantic แต่มักเป็นคุณสมบัติที่ผิวเผิน ไม่มีประโยชน์มากนักในหลายๆปัญหา และยังมีคุณสมบัติทางภาษาอีกหลายตัวที่ทั้ง word2vec และ GloVe ไม่สามารถจัดการได้ โดยเฉพาะอย่างยิ่งคุณสมบัติทางภาษาที่เกิดจากคำหลายๆคำมาประกอบกัน เช่น สำนวน หรือ คำแสลง หรือ คุณสมบัติการเปลี่ยนความหมายในเชิงปฏิเสธ (negation) — “ไม่”+กริยาอื่นๆ
ส่วนหนึ่งอาจจะเป็นเพราะว่า ในกระบวนการ Transfer learning โดยใช้ word2vec และ GloVe ไม่ได้สนใจบริบทในประโยค (do not take context into account) หรือก็คือ แต่ละคำ จะถูกเปลี่ยนเป็นเวกเตอร์หนึ่งแบบที่ตายตัว ไม่ว่าจะอยู่ในบริบทใดก็ตาม ซึ่งในความเป็นจริง คำจำนวนมากมีความหมายมากกว่า 1 ความหมาย เช่น คำว่า “Bank” สามารถหมายถึง ตลิ่ง หรือ ธนาคาร หรือ แม้กระทั้ง ชื่อคน
ATMs and Online Bankingservices will eventually replaced actual banks.
Bankand I were told that your cat was sicked. Is she better now?
Merlin, my cat, loves walking along river bankand catching a fish
ซึ่งความหมายของคำว่า Bank ในประโยคทั้ง 3 นี้ต่างใช้ในบริบทที่ต่างกันมากๆ ดังนั้นการใช้เวกเตอร์เดียวกันในทุกๆบริบท จึงเป็นเรื่องที่ไม่เหมาะสม มักจะทำให้เกิดความสับสนให้กับโมเดล และนำไปสู่โมเดลที่มีไม่มีประสิทธิภาพ
นี้จึงเป็นจุดเริ่มต้นของความพยายามในการสร้าง context-based representations หรือ โมเดลที่สามารถเปลี่ยนคำ/ประโยคไปเป็นเวกเตอร์ได้โดยใช้บริบทรอบๆ ประกอบในการสร้างเวกเตอร์ ความพยายามนี้ นำไปสู่การให้กำเนิด ELMo ตามมาด้วย GPT และ โมเดลอื่นๆอีกเป็นจำนวนมาก และหนึ่งในนั้นก็นำไปสู่การสร้าง BERT
Why BERT?
แล้ว BERT แตกต่างจากโมเดลอื่นๆยังไง?
หนึ่งในสิ่งจำเป็นสำหรับการใช้ Transfer Learning คือ โมเดลขนาดใหญ่หนึ่งตัว ซึ่งในงานทางด้าน computer vision โมเดลขนาดใหญ่นี้จะถูกสอนโดยใช้ข้อมูลจาก ImageNet โดยเริ่มต้นสอนให้มันแก้ปัญหา Image Classification จากนั้นในขั้นตอนถ่ายโอนความรู้ โมเดลที่ว่านี้จะถูกนำไปเทรนต่อด้วยข้อมูลใหม่ เพื่อแก้ปัญหาที่อื่นๆตามที่ต้องการ
คำถาม: แล้วงานทางด้าน NLP โมเดลขนาดใหญ่ที่ว่านี้ ควรเทรนด้วยปัญหาอะไร?
คำตอบของคำถามนี้ ยังถือเป็นข้อถกเถียงกันอยู่พอสมควร เพราะว่า งานทาง NLP มีความแตกต่างจากงานทาง Computer Vision ค่อนข้างมาก เพราะความซับซ้อนของภาษาที่มีองค์ประกอบหลายๆส่วนประกอบกัน ทั้งในด้านไวยกรณ์และด้านความหมาย นอกจากนี้ยังรวมไปถึงลักษณะของข้อมูลที่ต้องให้ความสำคัญกับลำดับของข้อมูล (Sequential) ข้อมูลมีความไม่ต่อเนื่อง (Discrete) และไม่ใช่ตัวเลข (Non-numerical)
แต่ทั้งนี้ นักวิชาการกลุ่มใหญ่ค่อนข้างมีความเห็นตรงกันว่า หนึ่งในปัญหาที่เหมาะสมที่สุด คือ ปัญหา Language Modelling ซึ่งมีเป้าหมาย คือ ทำนายคำที่จะเกิดขึ้นต่อไปจากคำตั้งต้นที่มีให้ เช่น
เพราะวันนี้ท้องฟ้าสดใส เจ้าเหมียวของฉันคงจะ____
จะเห็นได้ว่า โมเดลจำเป็นจะต้องเรียนรู้วิธีการใช้คำ คำไหนต้องใช้ร่วมกัน (Collocation) ไวยกรณ์ (Grammar) รวมไปถึงการทำความเข้าใจบริบทต่างๆ (Context)
นอกจากนี้ข้อได้เปรียบสำคัญของปัญหา Language Modelling เมื่อเทียบกับปัญหาอื่นๆ คือ ความเรียบง่ายของปัญหา เนื่องจาก ปัญหานี้เป็นปัญหาในกลุ่ม Unsupervised task ซึ่งสามารถใช้ข้อความที่อยู่ใน เอกสาร/หนังสือต่างๆ/เวปไซท์ ได้โดยตรง โดยไม่ต้องการผู้เชี่ยวชาญเข้ามาแยก/แบ่งข้อมูลเป็นกลุ่มๆ จึงพูดได้ว่า สามารถสร้างข้อมูลขนาดใหญ่สำหรับปัญหานี้ได้โดยใช้เงินลงทุนเพียงเล็กน้อย ด้วยเหตุนี้งานวิจัยจำนวนมากทางด้าน Transfer Learning จึงเลือกใช้ Language Modelling เป็นปัญหาเริ่มต้น เพื่อสร้าง context-based representations
แต่ปัญหาสำคัญของการสร้าง Language Model คือ บริบทที่จะสอนให้โมเดล มักมาจากแค่ทางเดียว เช่น มาจากคำที่อยู่ทางซ้ายอย่างเดียวในภาษาที่เขียนจากซ้ายไปขวา เมื่อนำ Language Model ที่ได้นี้ ไป Transfer Learning เพื่อแก้ปัญหาอื่นๆ เช่น Sentiment Analysis มักพบว่า มันทำงานได้ไม่ดี เนื่องจากงานประเภทนี้ต้องการการเข้าใจบริบทภาพรวมของทั้งประโยค (sub-optimal for sentence-level tasks)
ELMo แก้ไขปัญหานี้ โดยการใช้สอน LSTM (เป็นโมเดลในกลุ่ม RNNs ตัวนึง ซึ่งเก่งกว่า RNN ปกติ) พร้อมกันทีเดียว 2 ตัว โดยตัวนึงเรียนบริบทจาก ซ้ายไปขวา ส่วนอีกตัวเรียนจาก ขวาไปซ้าย จากนั้นจึงเอาเวกเตอร์ที่จากได้ชั้นสุดท้ายของ LSTM จากโมเดลทั้ง 2 ตัวมาต่อกัน ใช้เป็นเวกเตอร์ใหม่ เพื่อนำไปใช้ในการ Transfer learning ต่อไป
แต่ในทางกลับกัน GPT-1 จากทีม OpenAI แก้ปัญหานี้แตกต่างออกไป โดยการสร้าง Language model จากโมเดลใหม่ที่ดัดแปลงมาจาก Transformer ซึ่งใช้เทคนิค Self-Attention แทนที่การใช้ LSTM โดยให้เหตุผลว่าปัญหาที่เกิดขึ้นแท้ที่จริงแล้วมาจากปัญหาของ LSTM (หรือ RNN) ที่มักจะลืมข้อมูลที่ได้จากคำที่สอนไปแล้วก่อนหน้า และกระบวนการ Self-Attention ใน Transformer ก็สามารถแก้ปัญหานี้ไปแล้ว ดังนั้นจึงกล่าวได้ว่า แค่การใช้ Transformer ก็เพียงพอแล้วสำหรับการสร้าง Language Model
แต่เนื่องจาก Transformer ออกแบบมาเป็น sequence-to-sequence model เพื่อใช้ในปัญหาที่ต้องการเปลี่ยน sequence นึงไปยังอีก sequence นึง เช่น Machine Translation ซึ่งเมื่อเปลี่ยนมาใช้งานในรูปแบบของ Language Model จึงไม่มีความจำเป็นจะต้องใช้ทั้ง encoder และ decoder โมเดล GPT จึงเลือกเพียงแต่ส่วนที่เป็น decoder ที่อยู่ใน Transformer ด้วยเพราะว่า decoder ทำหน้าที่คล้ายกับการทำงานของ language model อยู่แล้ว (รับคำที่เจอมาก่อนหน้า จากนั้นทำนายคำที่จะอยู่ถัดไปจากคำนั้น) จึงสามารถทำงานเป็น Language Model ได้ทันที_— ถ้าใครอยากรู้เพิ่มเติม กดย้อนไปดูบทความ Transfermer ได้เลยครับ_
แต่อย่างไรก็ตาม ทีม Google AI ก็ยังไม่พอใจกับผลลัพท์ที่ได้ โดยอธิบายว่า แค่เอาเวกเตอร์จาก 2 บริบท มาต่อกับแบบ ELMo มันช่าง ตื้นเขิน ยิ่งนัก (just a shallow represnetation) เป็นแค่การแก้ปัญหาที่ปลายเหตุ ข้อมูลจากบริบททางซ้ายและบริบททางขวา ไม่ได้สัมพันธ์กัน และแน่นอนว่าทางออกที่ดีกว่า คือ Self-Attention !! แต่การใช้บริบททางเดียว เป็นการจำกัดความสามารถในการเรียนรู้ ทำให้ไม่สามารถเรียนรู้คุณสมบัติทางภาษาบางอย่างได้
BERT จึงเป็นความพยายามในการออกแบบ Language Model ที่สามารถเรียนรู้จากทั้งบริบทที่อยู่ทางซ้าย และขวา พร้อมๆกัน โดยใช้เทคนิค Self-Attention
BERT Architecture
หากพิจารณาชื่อเต็มๆของ BERT หรือ Bidirectional Encoder Representations from Transformers จะเห็นได้ว่า BERT เป็นอีกหนึ่งโมเดลที่ต่อยอดจาก Transformer คล้ายๆกับ GPT
โดย BERT ต่างจาก GPT เนื่องจากมันถูกออกแบบให้เลือกใช้เฉพาะส่วนที่เป็น encoder ซึ่งทำหน้าที่แปลงคำในประโยคให้เปลี่ยนไปเป็นเวกเตอร์ (แต่ GPT เลือกใช้ decoder) เพื่อให้ encoder สามารถทำหน้าที่เป็น Language Model ได้ BERT จึงเพิ่มโมเดลอีก 1 ตัว ต่อจาก encoder ที่มีอยู่เดิม เพื่อทำหน้าที่เป็น Classifier นำเวกเตอร์ที่ได้จาก encoder ไปคำนวนต่อให้ได้คำตอบในรูปแบบคล้ายๆกับ Language Model ทั่วๆไป
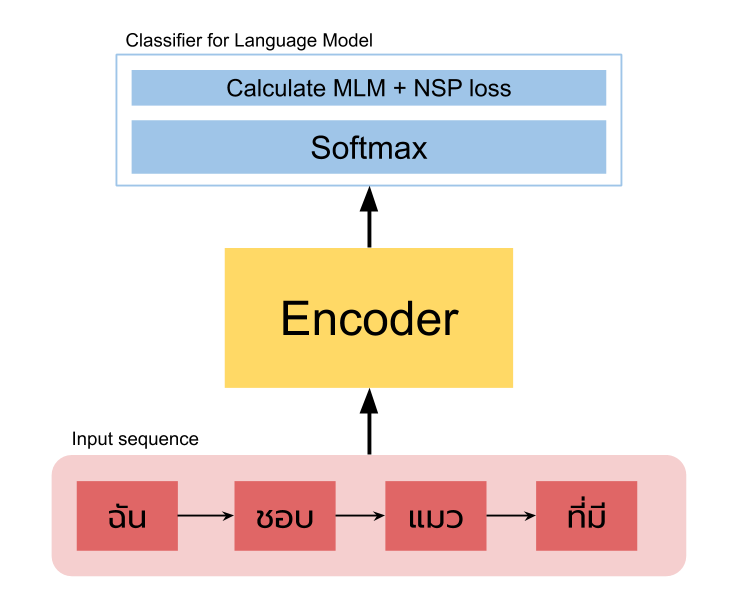
ดังนั้น ในภาพรวมแล้ว BERT ไม่ต่างจาก Transformer Encoder มากนัก ส่วนต่างที่ชัดที่สุด อาจจะเป็นเรื่องของขนาด โดย BERT ขยายขนาดให้มีจำนวน attention head มากขึ้น มีจำนวน layer มากขึ้น และ เพิ่มขนาด embedding vector ทั้งนี้ เพื่อให้มั่นใจว่าโมเดลสามารถเรียนรู้คุณสมบัติทางภาษาให้ได้มากที่สุด (ตามทฤษฎี ยิ่ง NeuralNet มีขนาดใหญ่ๆ/หลายๆเลเยอร์ ยิ่งสามารถเรียนรู้ความสัมพันธ์ที่ซับซ้อนได้ดี) โดย pre-trained models จากเปเปอร์ มี 2 ขนาด คือ
bert-base: 12 layers, 768 hidden units, 12 heads, ~110M parameters in total
bert-large: 24 layers, 1024 hidden units, 16 heads, ~340M parameters in total
โดย bert-base ออกแบบมาให้มีขนาดใกล้เคียงกับ GPT เพื่อใช้ในการวัดผลและเปรียบเทียบ และ bert-large ออกแบบมาเพื่อทดสอบขีดความสามารถของ BERT ซึ่งจะพูดถึงในต่อไป
แต่นอกจากขนาดโมเดลที่ใหญ่กว่าเดิม อีกองค์ประกอบสำคัญที่ BERT แตกต่างจาก Transformer Encoder คือ activation function โดยมีการเปลี่ยนจาก ReLU ที่ใช้ใน Transformer เป็น GELU (Gaussian Error Linear Unit)
โดย GELU เป็นการเพิ่มความสามารถให้กับ ReLU เพื่อแก้ปัญหา Dead neurons ซึ่งเกิดขึ้นเมื่อข้อมูลจาก neurons มีค่าน้อยกว่า 0 จำนวนมาก โดยค่าที่เป็นลบเหล่านี้ จะส่งผลให้ ReLU ให้ผลลัพท์เป็น 0 ไปด้วย มีผลต่อเนื่องทำให้ไม่เกิดการอัพเดตใน neurons กลุ่มนั้นไปตลอดการเทรน
GELU แก้ไขปัญหานี้ด้วยสมการใหม่ โดยยังคงผลลัพท์แบบเดิม เมื่อในช่วงที่ข้อมูลนำเข้ามีค่ามากกว่า 0 {GELU(x) ~ x; x > 0} และแก้ไขผลลัพท์ในช่วงข้อมูลที่มีค่าน้อยกว่า 0 เพื่อให้มีการเปลี่ยนแปลงเล็กน้อย ไม่ให้เกิด dead neurons
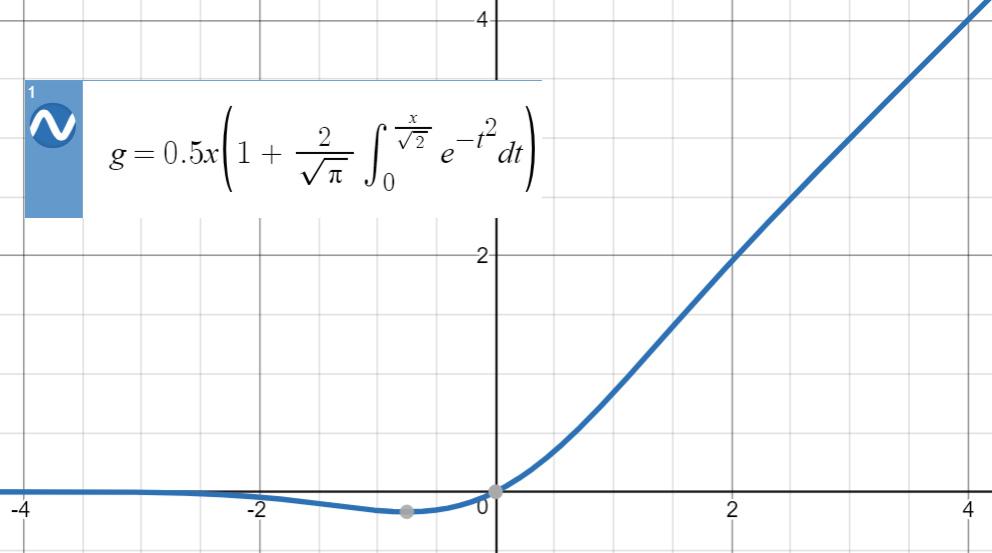
กราฟ activation ของ GELU ทั้งนี้สมการข้างต้นเป็นเพียงการประมาณค่าของสมการจริงๆ https://datascience.stackexchange.com/questions/49522/what-is-gelu-activation
ที่น่าสนใจ คือ จากการทดลองพบว่า การใช้ GELU เมื่อเทียบกับ ReLU แล้ว มันทำให้โมเดลเรียนรู้เร็วขึ้น มีความแม่นยำมากขึ้น และสามารถจัดการกับ noise ได้ดีขึ้น แต่อย่างไรก็ตาม ยังมี Activation functions ใหม่ๆ อีกหลายๆตัว ออกแบบมาแก้ปัญหาเดียวกันนี้ เช่น Leaky-RELU, ELU, Swish เป็นต้น แต่ยังไม่มีเหตุผลที่ชัดเจนว่า GELU ดีกว่า Activation functions อื่นๆ อย่างไร? ทั้งนี้ในเปเปอร์อธิบายว่า เหตุผลการเลือก GELU นี้ เป็นเพียงเพราะต้องการให้ BERT มีความใกล้เคียงกับ GPT ซึ่งใช้ GELU มาก่อน — เลือกตามๆกันไปนั้นเอง
ต่อมาเข้าสู่ขั้นตอนการเทรน BERT ซึ่งจะแบ่งเป็น 2 ขั้นตอน คือ Pre-training เป็นขั้นตอนการสอนเพื่อให้โมเดลเรียนรู้โครงสร้างภาษาในภาพรวม ซึ่งจะสอนด้วยข้อมูลปริมาณมากๆ จากนั้นตามด้วย Fine-tuning ซึ่งจะสอนโมเดลอีกครั้ง เพื่อให้โมเดลปรับตัวเอง สำหรับปัญหาใดปัญหาหนึ่งที่ผู้พัฒนาต้องการ
Pre-Training BERT
มาถึงส่วนแรกของการเรียนรู้แบบ BERT ซึ่งเป็นเบื้องหลังของความสำเร็จของ BERT เลยก็ว่าได้
เพื่อสร้าง Language Model ที่สามารถเรียนรู้จากบริบทที่มาจากคำที่อยู่ทางซ้ายและขวา ทีม Google AI ตัดสินใจเปลี่ยนโจทย์ Language Model แบบเดิมๆ ซึ่งเป็นการทำนายคำที่จะเกิดขึ้นต่อไปจากประโยคตั้งต้น มาเป็นการเทรนด้วยโจทย์ใหม่ 2 โจทย์ คือ
1. Masked Language Model
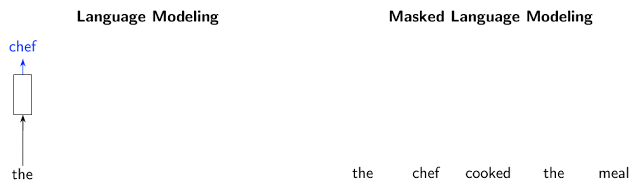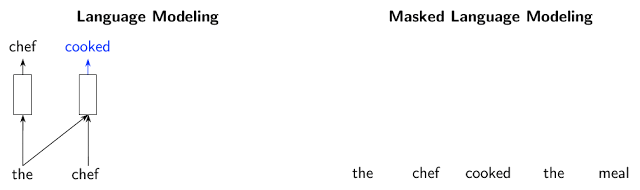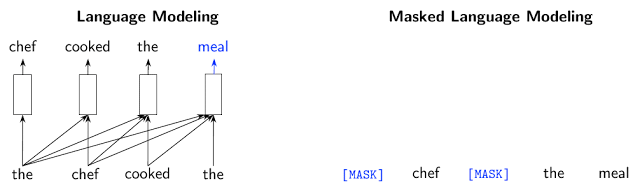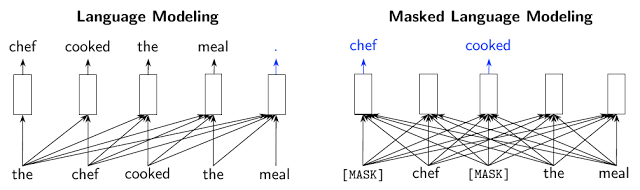
Masked Language Model หรือ MLM ถูกออกแบบมาเพื่อใช้แทนที่ Language Model แบบดั้งเดิม โดยในแต่ละรอบของการสอนโมเดล ประโยคจำนวนหนึ่งจะถูกป้อนเข้ามา โดยที่ประมาณ 15% ของคำทั้งหมดจะโดนลบออกไป (Masked words) และ สิ่งที่โมเดลต้องทำ คือ การเติมคำที่หายไปเหล่านั้นให้ถูกต้อง ซึ่งเพื่อเติมคำที่ถูกต้อง โมเดลต้องเข้าใจโครงสร้างของประโยคเช่นเดียวกับ Langauge Model แบบดั้งเดิม แต่ทั้งนี้โมเดลสามารถพิจารณาบริบทได้จากทุกคำที่อยู่รอบๆ จึงถือได้ว่า MLM เป็นคำตอบในอุดมคติที่ทีม Google AI ตามหา
แต่ปัญหาหนึ่งที่มักเกิดขึ้น หลังจากโมเดลเรียนรู้ภายใต้ข้อมูลแบบ MLM ไปสักระยะหนึ่ง คือ โมเดลมักจะพยายามที่จะเดาคำที่หายไปเพียงอย่างเดียว จนไม่สนใจคำอื่นๆเลย (the model only tries to predict the [MASK] token) เวกเตอร์ของคำอื่นๆที่ได้จึงมีแนวโน้มว่า จะไม่มีข้อมูลที่มีประโยชน์ (might not be as rich as it could be) โดยเฉพาะอย่างยิ่ง เมื่อต้องการนำไปใช้การ Transfer learning นอกจากนี้แล้ว ในการเชิงปฏิบัติมักจะพบว่า การเรียนรู้เพื่อแก้ปัญหา MLM ต่างกับปัญหาที่มันต้องเรียนรู้ในขั้นตอน Fine-tuning ค่อนข้างมาก เนื่องจากมีการใช้ [MASK] token แค่เพียงเฉพาะในขั้นตอน Pre-training แต่ข้อมูลที่ใช้สอนในขั้นตอน Fine-tuning มักจะไม่มีการลบคำบางคำออกไป หรือ ก็คือ ไม่ได้ใช้ [MASK] token (the [MASK] token does not appear during fine-tuning/testing time) จึงมีแนวโน้มทำให้โมเดลไม่สามารถจัดการปัญหาอื่นๆได้ เพราะ ธรรมชาติของปัญหาต่างกันเกินไป
ทางออกที่ถูกนำเสนอขึ้นมา คือ Mixed Mask Strategy โดย ภายใน 15% ของคำที่ทั้งหมดออกไป จะถูกแบ่งออกเป็น
- 80% ของคำที่หมด จะโดนแทนที่ด้วย [MASK] token
- 10% ของคำที่หมด จะโดนแทนที่ด้วยคำอื่นๆแบบสุ่ม
- 10% ของคำที่หมด จะไม่โดนเปลี่ยนแปลง
เนื่องจาก BERT จะคำนวน loss จากเฉพาะในส่วนที่เป็น 15% ที่เลือกมาในรอบแรก และบางส่วนของคำถาม ไม่ใช่ [MASK] token อีกต่อไป โมเดลจึงต้องสนใจทุกๆ Token โดยการคงให้คำบางส่วนอยู่เหมือนเดิม จะช่วยให้โมเดลสามารถสร้างเวกเตอร์ที่ตรงตามคำที่เจอจริงๆได้ง่ายขึ้น (to bias the representation towards the actual observed word) และการแทนที่คำด้วยคำอื่นแบบสุ่มนี้ เป็นการเพิ่ม noise ให้กับโมเดล คล้ายๆกับการทำ regularisation เพื่อแกล้งโมเดล ไม่ให้มันมั่นใจเกินกับคำตอบตัวเองจนเกินไป
อย่างไรก็ตาม การปรับสัดส่วนนี้ มีผลอย่างมากต่อประสิทธิภาพในภาพรวมของโมเดล โดยเฉพาะ การแทนที่คำด้วยคำอื่น ซึ่งมีแนวโน้มจะทำให้โมเดลสับสน และมีผลทำให้ประสิทธิภาพของโมเดลลดลง การเลือกสัดส่วนที่เหมาะสมจึงเป็นเรื่องสำคัญ ทั้งนี้ สัดส่วน 80–10–10 ที่เห็นในเปเปอร์ เป็นสัดส่วนที่ดีที่สุดจากการทดสอบหลายๆครั้ง ซึ่งสามารถดูได้จากตารางด้านล่าง
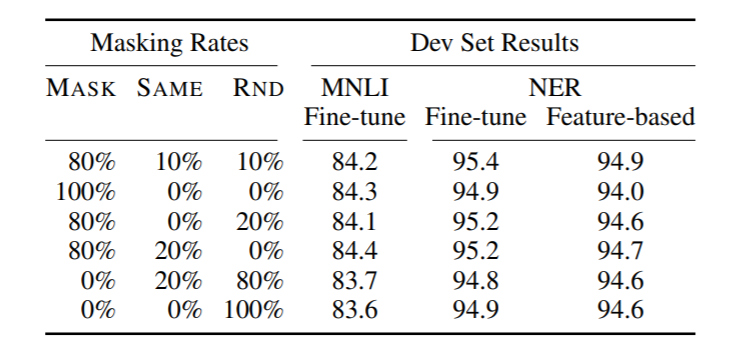
ข้อมูลการทดสอบ Mask strategy ด้วยสัดส่วนหลายๆรูปแบบ cc: https://arxiv.org/abs/1810.04805
2. Next Sentence Prediction
เนื่องจากปัญหาในงาน NLP ค่อนข้างมีความหลากหลาย เช่น NER, POS tagging, Tokenizing ปัญหากลุ่มนี้ ถือได้ว่าเป็นปัญหาที่อยู่ในระดับคำ กล่าวคือ โมเดลต้องประมวลผลเพื่อทำนายคำตอบสำหรับแต่ละคำๆ ซึ่งแค่ MLM ก็เพียงพอในการจัดการปัญหากลุ่มนี้ได้เป็นอย่างดี
แต่ยังมีปัญหากลุ่มใหญ่อีกกลุ่มหนึ่ง เช่น Sentiment Analysis, Question Answering, Summarisation ซึ่งเป็นปัญหาในระดับประโยค โมเดลต้องอาศัยความเข้าใจในภาพรวมของทั้งประโยคเพื่อสรุปออกมาเป็นคำตอบที่ต้องการ แต่เนื่องจาก MLM ถูกออกแบบมาให้ประมวลผลในระดับคำ ดังนั้นมันจึงมีแนวโน้มว่า จะไม่สามารถทำความเข้าใจภาพรวมในลักษณะนี้ได้ดี
BERT แก้ไขปัญหานี้ด้วยการเพิ่มโจทย์ Next Sentence Prediction หรือ NSP ไปพร้อมๆกับการทำ MLM เพื่อให้โมเดลเรียนรู้ความสัมพันธ์ระหว่างประโยค โดยการป้อน 2 ประโยค จากนั้นให้โมเดลตัดสินว่า ประโยคทั้ง 2 นี้เป็นประโยคที่อยู่ติดกันหรือไม่? โดยแบ่งข้อมูลครึ่งนึง เป็นคู่ของประโยคที่อยู่ติดกัน และอีกครึ่งนึงเป็นประโยคที่โดนจับคู่กันแบบสุ่ม
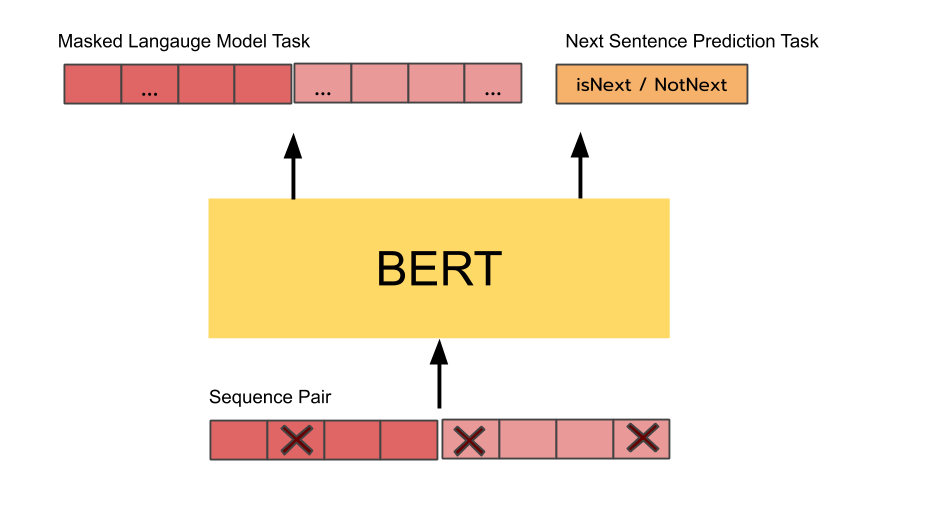
ดังนั้นในภาพรวม ในแต่ละรอบของการสอน BERT จะรับคู่ของประโยค ซึ่งจะมีคำบางส่วนหายไป จากนั้น BERT ก็จะพยายามทายคำในช่องว่าง พร้อมกับทายว่าประโยคทั้ง 2 อันที่ได้รับมา เป็นประโยคที่อยู่ติดกันหรือไม่? แล้วนำคำตอบที่ได้จากทั้ง 2 คำถามไปคำนวนความถูกต้อง และอัพเดตโมเดล สิ่งนี้ทำให้ BERT สามารถเรียนรู้ความสัมพันธ์ทั้งในระดับคำ และระดับประโยคไปพร้อมๆกัน
Training Data
เนื่องจาก BERT เทรนด้วยโจทย์ที่เป็น Unsupervised tasks ดังนั้นข้อมูลที่ใช้ในการสอนโมเดลสามารถเป็นบทความจากหนังสือ หรือ ข้อมูลจากเวปไซท์ต่างๆได้โดยตรง ซึ่งในที่นี้ BERT ถูกเทรนด้วยข้อมูลขนาดใหญ่จำนวน 2 ก้อน คือ BooksCorpus (800 ล้านคำ) และ บทความจาก Wikipedia ภาษาอังกฤษ (2500 ล้านคำ)
จากข้อมูลที่ได้มา BERT เตรียมข้อมูลโดยใช้เทคนิคเช่นเดียวกับ Transformer โดยเริ่มต้นจากการเปลี่ยน words เป็น subwords เพื่อแก้ปัญหา out-of-vocab และ rare words แต่ที่น่าสนใจ คือ BERT ใช้เทคนิคใหม่ที่ชื่อว่า WordPiecesแทนที่ BPE ใน Transformer
โดยทั้ง Wordpieces และ BPE ต่างมีการทำงานคล้ายๆกัน คือ เริ่มต้นจากการสร้างเซตของตัวอักษรทั้งหมด จากนั้นจึงค่อยๆรวม vocab เข้าด้วยกัน เพื่อสร้างเป็น vocab ใหม่ โดยส่วนที่ Wordpieces ต่างกับ BPE คือ เงื่อนไขในการรวม vocab ซึ่ง BPE พิจารณาจากคู่ vocab ที่พบบ่อยที่สุด แต่ใน Wordpieces พิจารณาจากจากค่าความน่าจะเป็น โดยเลือกคู่ของ vocab ที่มีโอกาสในการเจอมันคู่กันมากที่สุด เมื่อเทียบกับโอกาสที่เจอมันแยกกันเดี่ยวๆ [เพิ่มเติม] — จะว่าไปแล้วการคำนวนในส่วนนี้ไม่มีการนำโค้ดออกมาเปิดเผย และในเปเปอร์ไม่ได้ลงรายละเอียดในส่วนนี้มากนัก แต่ในการพัฒนา สามารถใช้ Wordpiece Tokenizer ที่มาพร้อมกับ BERT ได้เลยโดยไม่ต้องคำนวนใหม่ด้วยตัวเอง
สุดท้ายนี้ เพื่อเตรียมข้อมูลให้พร้อมสำหรับ MLM และ NSP tasks ประโยคทั้งหมดจะถูกจับคู่ จากนั้น ในแต่ละคู่ของประโยค จะโดนนำเข้าไปยังขั้นตอนการแปลงไปเป็นเวกเตอร์ โดยเริ่มต้นจากการเพิ่ม tokens พิเศษ 2 ตัว คือ
[CLS] token เพื่อใช้แทนตำแหน่งเริ่มต้นของข้อมูล
[SEP] token คั้นกลางระหว่างประโยคทั้ง 2 เพื่อกำหนดขอบเขตระหว่างประโยคที่ 1 และ ประโยคที่ 2
จากนั้น นำ tokens ทั้งหมด จะถูกนำไปยำๆให้กลายเป็นก้อนของตัวเลข โดยผ่าน Embedding 3 ตัว คือ
- Token embeddings: เป็น Trainable Parameters ซึ่งระหว่างการเทรนโมเดล Embedding ชั้นนี้จะค่อยๆปรับตัวเอง เพื่อแทนข้อมูลในระดับคำของแต่ละ token
- Positional embeddings: เทคนิคเดียวกับที่ใช้ใน Transformer เพื่อเพิ่มข้อมูลเกี่ยวกับตำแหน่งของคำต่างๆ ให้กับโมเดล
- Segment embeddings: เป็น Embedding ใหม่ ที่เพิ่มเข้ามาใน BERT เพื่อช่วยให้โมเดลสามารถแยกแยะ ระหว่างประโยคที่ 1 และ ประโยคที่ 2 ที่อยู่ในข้อมูล ( เป็น Trainable Parameters เช่นเดียวกับ Token embeddings)
โดยทั้ง Segment embeddings และ [SEP] ต่างเป็นส่วนที่ช่วยในการระบุขอบเขตของประโยค ทั้งนี้ผู้เขียนไม่มั่นใจว่า ทำไมต้องมีความทับซ้อนกัน ประโยชน์หนึ่งที่เป็นไปได้ คือ ทำให้โมเดลแยกความแตกต่างระหว่างประโยคได้เร็วขึ้น เนื่องจากมีข้อมูลจากหลายๆอันประกอบเข้าด้วยกัน
โดยทั้ง 3 Embeddings จะโดนนำมารวมกัน และป้อนให้กับโมเดลไปคำนวนในชั้นอื่นๆต่อไป
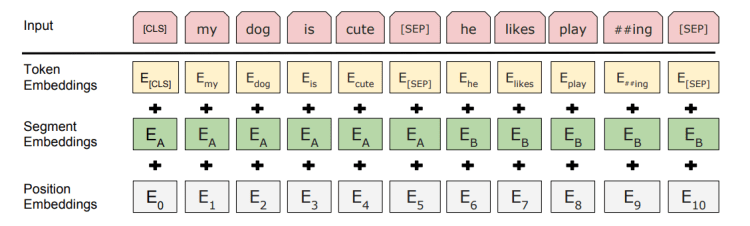
ภาพรวมของ Input vectors สำหรับเทรน BERT
Training Hyperparameters
สำหรับค่าตัวแปร hyperparameters ต่างๆที่ใช้ในการเทรน BERT ส่วนใหญ่แล้วใช้ค่าเดียวกับที่ใช้ใน Transformer เช่น Learning rate schedule, Dropout probability etc ทั้งนี้ด้านล่างเป็นค่าบางส่วนที่กล่าวถึงในเปเปอร์
- Sequence length : 256 tokens (ถ้ายาวมากกว่านี้ จะโดนตัดออกไป)
- Batch size: 512
- Training steps: 1,000,000 (Approximately 40 epochs)
- Optimizer: Adam with β1 = 0.9, β2 = 0.999
- Learning rate: 1e-4 with L2 weight decay of 0.01
นอกจากนี้ อีกเทคนิคหนึ่งที่มีการกล่าวถึงในเปเปอร์ เพื่อลดระยะเวลาในการสอนโมเดล คือ การแบ่ง training data เป็น 2 กลุ่ม ตามความยาวของข้อมูล โดย 90% แรกของของ training steps จะถูกเทรนด้วย ข้อมูลก้อนที่มีข้อมูลสั้นกว่า จากนั้น 10% ที่เหลือ จึงค่อยเทรนด้วยข้อมูลก้อนที่เหลือ เนื่องด้วยว่า Time complexity ของ self-attention ขึ้นกับความยาวของประโยค (ยกกำลัง 2) ดังนั้นข้อมูลที่ยาวมากกว่า จะใช้เวลาในการเทรนมากกว่า การทำแบบนี้จะลดระยะเวลาเทรนไปได้มาก โดยไม่กระทบกับความแม่นยำของโมเดล เนื่องจากในช่วงแรก โมเดลต้องเรียนรู้คุณสมบัติทางภาษาในภาพรวมก่อนซึ่งไม่จำเป็นจะต้องใช้ประโยคยาวๆ แต่ในช่วงท้าย โมเดลต้องเรียนรู้ความสัมพันธ์ระหว่างคำและประโยค ประโยคที่ยาวๆจึงมีความสำคัญมากขึ้น — ทั้งนี้คำอธิบายนี้ มาจากความคิดส่วนตัว ไม่ได้มีอธิบายในรายละเอียดในเปเปอร์ และ ผูู้เขียนก็ไม่เห็น implementation ของเทคนิคนี้ใน official repo เลยมีความไม่มั่นใจเล็กน้อยในรายละเอียด
Fine-Tuning BERT
หลังจากที่ได้ Pre-trained BERT แล้วขั้นตอนสุดท้ายที่ขาดไม่ได้ คือ การ Fine-tuning หรือ การปรับรายละเอียดของโมเดลให้เหมาะสมกับงานที่ต้องการ ซึ่งในเชิงปฏิบัติ Fine-tuning คือ การสอนโมเดลอีกรอบด้วยข้อมูลที่ใช้สำหรับงานตามที่ต้องการ
โดยเพื่อทำการ Fine-tuning ผู้พัฒนาต้องทำเพียงแค่ แทนที่ Classifier เดิมด้วย Classifier ตัวใหม่ซึ่งมี input/output units แบบที่ต้องการ ซึ่งในเปเปอร์ได้ตัวอย่างการใช้งาน BERT ในปัญหาประเภทต่างๆ ดังนี้
กลุ่มปัญหาระดับคำ หรือ Token-level tasks ปัญหาในกลุ่มนี้ ส่วนใหญ่มักอยู่ในรูปแบบของ multiclass/binary classification เช่น
- Named Entity Recognition หรือ NER ซึ่งต้องการหาตำแหน่ง และจัดหมวดหมู่ของกลุ่มคำที่เป็น ชื่อคน ชื่อองค์กร สถานที่ ตัวอย่างบททดสอบสำหรับปัญหานี้ คือ CoNLL-2003 NER
- POS tagging ซึ่งต้องการระบุประเภทของคำ เช่น Noun, Verb, Adjective เป็นต้น
BERT สามารถ Fine-tuning เพื่อแก้ปัญหาในกลุ่มนี้ โดยการนำเวกเตอร์แต่ละคำที่ได้จาก BERT ส่งต่อไปให้ Classifier ประมวลผลต่อเพื่อทำนายว่า คำๆนี้อยู่ในกลุ่มอะไร? จากนั้นนำคำตอบที่ได้ไปอัพเดตโมเดลต่อไปทั้งในส่วนที่เป็น Classifier และ BERT และทำซ้ำไปเรื่อยๆ จนกว่าจะได้ระดับความแม่นยำที่ต้องการ
แต่บางคนอาจจะสงสัยว่า BERT ประมวลผลด้วย subword หนิ? แปลว่า หนึ่งคำอาจจะถูกเปลี่ยนเป็นเวกเตอร์หลายๆชิ้นก็ได้ จะจัดการกับปัญหานี้ยังไง? BERT เลือกใช้เฉพาะเวกเตอร์ของ subword แรก เพียงตัวเดียว เป็นตัวแทนของ word และใช้วิธีการเดิมที่อธิบายไปในย่อหน้าก่อน โดยจากทดลองพบว่า แค่เวกเตอร์แรกเพียงอย่างเดียว ก็สามารถพิชิต CoNLL-2003 NER ด้วย F1 score สูงถึง 92.8 (เต็ม 100)
อีก 1 ตัวอย่างปัญหาที่ไม่ใช่ multiclass classification ซะทีเดียว คือ Question Answering ซึ่งอยู่ในบททดสอบที่ชื่อ SQuAD v1.1 และ v2.0 ในบททดสอบนี้ จะให้ข้อมูลนำเข้าเป็นประโยค 2 ประโยค คือ คำถาม และข้อความที่(อาจจะ)มีคำตอบที่ต้องการ โดยโมเดลจะต้องตัดสินใจว่า ข้อความที่ให้มามีคำตอบที่ต้องการอยู่หรือไม่? (เฉพาะใน SQuAD v2.0) และ ถ้ามี คำตอบที่ว่าอยู่ตรงส่วนไหนของข้อความ?
BERT แก้ปัญหานี้ในรูปแบบคล้ายๆกับการทำ multiclass classification โดยใช้รูปแบบข้อมูลนำเข้าเป็นคู่ของประโยค และมี [SEP] token ในการระบุขอบเขตของประโยค จากนั้นเวกเตอร์ของแต่ละคำจาก BERT จะโดนประมวลผลต่อใน Classifier เพื่อให้คะแนนความน่าจะเป็นที่จะเป็น class labels 2 ตัว คือ start และ end แล้วจึงนำคะแนนที่ได้ใช้เพื่อคำนวนความน่าจะเป็น และ เลือกส่วนของประโยคอ้างอิงที่มีความน่าจะเป็นสูงที่สุดที่จะเป็นคำตอบ
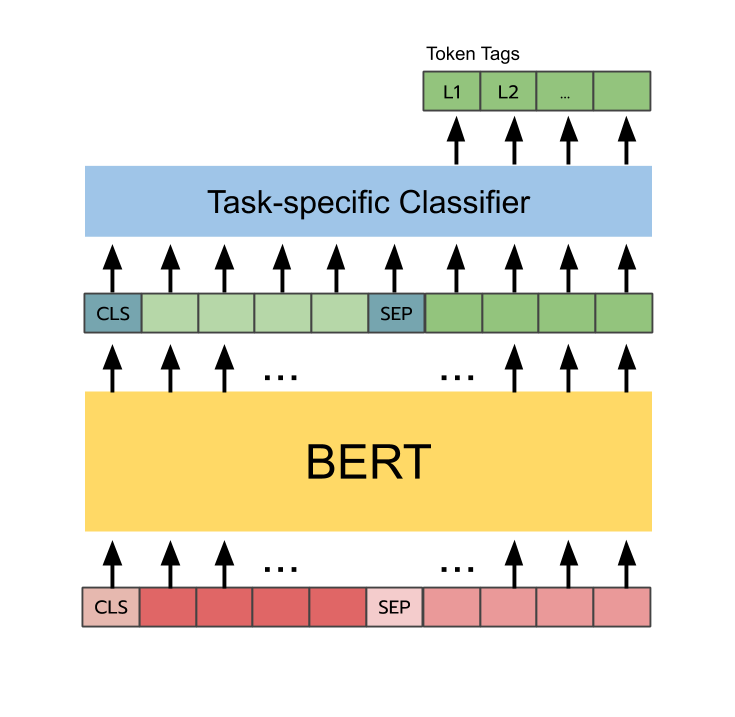
ตัวอย่างการทำ fine-tuning เพื่อแก้ปัญหาที่อยู่ในระดับคำ
กลุ่มปัญหาระดับประโยค หรือ Sentence-level tasks
ปัญหาในกลุ่มนี้ มักต้องการการประมวลผลภาพรวมของทั้งประโยค ดังนั้น BERT จึงเลือกใช้ [CLS] token (ซึ่งจะโดนใส่เป็น token แรกของทุกๆประโยค ทุกครั้งก่อนเริ่มประมวลผลประโยคนั้นๆ) เป็นตัวแทนของภาพรวมที่ว่า
โดยในการ Fine-tuning ในปัญหาประเภทนี้ จะเป็นการนำเวกเตอร์ที่เป็นผลลัพย์ของ [CLS] token ไปใส่ Classifier เพื่อคำนวนคำตอบ
ตัวอย่างของปัญหากลุ่มนี้ เช่น
- Semantic Textual Similarity: ต้องการให้คะแนนความเหมือนกันในเชิงความหมายระหว่างประโยค
- Natural Language Inference: ต้องการระบุว่าประโยคที่ได้รับมาเป็นเหตุเป็นผลกันหรือไม่ (เป็นเหตุเป็นผลกัน, ขัดแย้งกัน, ไม่เกี่ยวกัน)
- Sentiment Analysis: ต้องการระบุว่าประโยคที่ได้รับมามีความหมายในแง่บวก หรือ ลบ
ข้อมูลนำเข้าในปัญหากลุ่มนี้มีทั้งที่อยู่ในรูปแบบของคู่ของประโยค และประโยคเดี่ยวๆ ซึ่งทั้งสองรูปแบบสามารถนำไป Fine tuning ได้ด้วยการใช้ [SEP] token
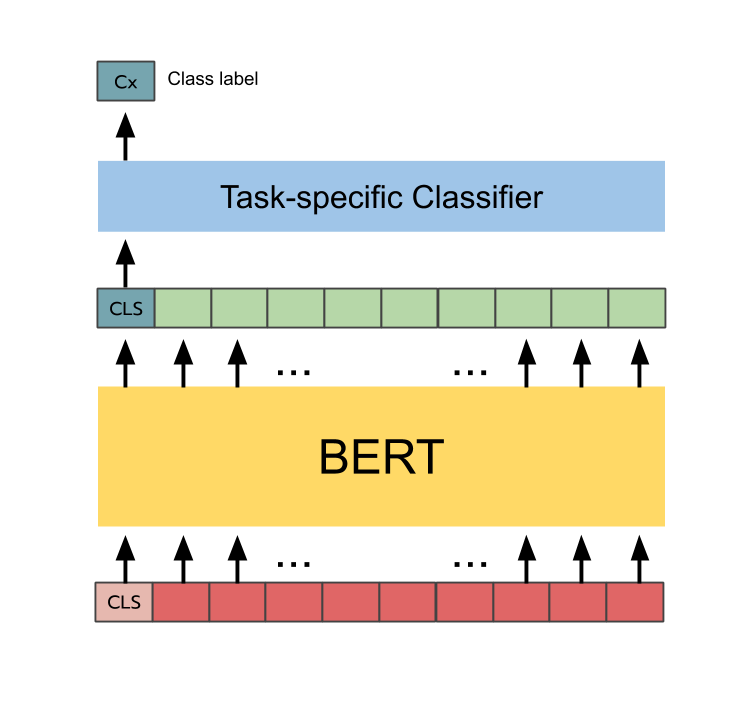
ตัวอย่างการทำ fine-tuning เพื่อแก้ปัญหาที่อยู่ในระดับประโยค
อีกรูปแบบหนึ่งของโจทย์ที่ยังไม่ได้กล่าวถึง คือ โจทย์ที่ให้เลือกคำตอบจากหลายๆตัวเลือก เช่น Commonsense Inference ซึ่งอยู่ในบททดสอบ SWAG ในบททดสอบนี้จะประกอบด้วยคำถาม และคำตอบ 4 ตัวเลือก
BERT จัดการปัญหานี้ ได้ด้วยการใส่ข้อมูลนำเข้าเป็นคู่ๆ ระหว่างคำถาม และคำตอบในตัวเลือกต่างๆ จากนั้นนำข้อมูลนำเข้าทั้งหมดไปประมวลผลใน BERT แล้วเลือกใช้ เวกเตอร์ผลลัพท์ของ [CLS] token ของแต่ละตัวเลือกเป็นตัวแทนไปคำนวนต่อใน Classifier เพื่อเลือกคำตอบที่มีความน่าจะเป็นสูงที่สุด
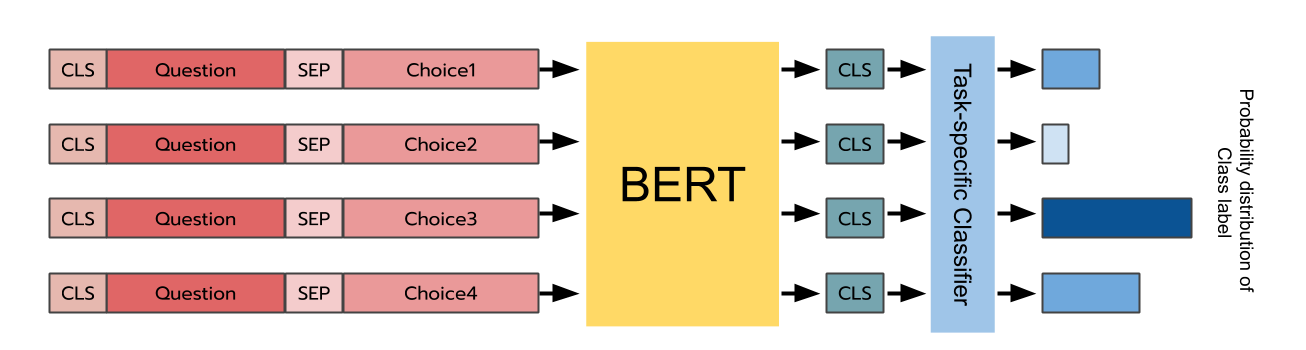
ทั้งนี้ วิธีการ Fine-tuning ที่เห็น เป็นเพียงแค่คำแนะนำจากในเปเปอร์ ผู้พัฒนาสามารถเปลี่ยนแปลง หรือ ใช้รูปแบบอื่น ได้ตามที่ต้องการ
แต่ถึงแม้ว่าจะมีรูปแบบที่สามารถในการจัดการกับปัญหาที่หลากหลาย สิ่งที่สำคัญ คือ ระยะเวลา และ ปริมาณข้อมูลที่ต้องใช้ในการ fine-tuning เพราะ ถ้าต้องเสียเวลานาน หรือ ต้องการข้อมูลมากๆ การใช้งานโมเดลในเชิงปฏิบัติจริงๆคงจะเป็นเรื่องที่ยาก
แต่ที่น่าตกใจ คือ จากการทดลองพบว่า BERT ต้องการการ fine-tuning เพียง 3–4 epochs เท่านั้นเอง ใช้เวลาแค่เพียงไม่กี่ ชม. ซึ่งน้อยมากๆ เมื่อเทียบกับการสร้างโมเดลแบบเดิมๆให้ได้ความแม่นยำระดับเดียวกัน โดยเปเปอร์แนะนำการตั้งค่า hyperparameters ดังนี้
- Dropout: 0.1
- Batch size: 32, 16
- Optimizer: Adam
- Learning rate: 5e-5, 3e-5, 2e-5
- Number of epochs: 3, 4
และเพราะว่า BERT ใช้เวลา fine-tuning เพียงแค่ไม่กี่ ชม. ในเปเปอร์จึงมีคำแนะนำให้ทดสอบ fine-tuning แบบ grid search ไปเลยก็ได้ ้หากกำลังหาโมเดลที่ดีที่สุด — หรือ ทุ่มเงินเข้าไป โยนตังค์ๆ ทุกอย่างแก้ปัญหาได้ด้วยการซื้อ GPU เพิ่ม [ผู้เขียน]
Feature extraction
นอกจาก Fine-tuning แล้ว ยังมีอีกหนึ่งเทคนิค Transfer learning ที่เรียกว่า Feature extraction ซึ่งใช้ใน ELMo ที่เคยอ้างถึงไปก่อนหน้านี้
โดย Feature extraction เป็นการสอนโมเดล 2 รอบ ในรูปแบบเดียวกับ Fine-tuning แต่ในการสอนรอบที่ 2 เทคนิคนี้ไม่อัพเดตทั้งโมเดล แต่จะอัพเดตเฉพาะในส่วนที่เป็น Classifier ที่เพิ่มเข้ามา หรือพูดอีกรูปแบบหนึ่ง คือ feature extraction จะการนำข้อมูลนำเข้าทุกๆตัวไปเปลี่ยนเป็นเวกเตอร์ก่อน จากนั้นจึงเอาเวกเตอร์ที่ได้มาไปสอน Classifier โดยไม่ต้องไปแก้ไข pre-trained model
ความเรียบง่ายของวิธีนี้ คือ สามารถนำข้อมูลนำเข้าที่จะใช้ในการสอนรอบที่ 2 ไปเปลี่ยนเป็นเวกเตอร์ได้ก่อนล่วงหน้า ขณะที่สอนจึงไม่จำเป็นต้องนำข้อมูลไปคำนวนใน pre-trained model อีก ทำให้การสอน classifier ทำได้เร็วกว่า fine-tuning มากๆ และประหยัดพื้นที่ของ GPU (ไม่ต้องโหลด pre-trained model เข้า GPU RAM) ซึ่งอาจจะมีประโยชน์อย่างมากในระบบที่มีข้อจำกัดมากๆ เช่น ในมือถือ หรือ ในอุปกรณ์อิเล็กโทรนิคส์ขนาดเล็ก
โดยเวกเตอร์ที่จาก pre-trained model สามารถนำไปใช้ได้ เป็น feature ในหลายๆรูปแบบ เช่น
- ใช้เฉพาะเวกเตอร์จาก layer แรก
- ใช้เฉพาะเวกเตอร์จาก layer สุดท้าย
- ใช้เวกเตอร์จาก 4 layer สุดท้าย มาบวกกัน
- ใช้เวกเตอร์จาก 4 layer สุดท้าย มาต่อกันเป็นเวกเตอร์ขนาดใหญ่ๆหนึ่งอัน
(โดยปกติแล้ว layer หลังๆ จะมีข้อมูลที่มีประโยชน์มากกว่า layer แรกๆ)
ทั้งนี้ การทำ Feature extraction จึงจำเป็นจะต้องทดลองสร้าง feautre ในหลายๆรูปแบบ เพื่อหาโมเดลที่ดีที่สุด
แต่อย่างไรก็ตาม จากงานวิจัยหลายๆชิ้นพบว่า feature extraction ค่อนข้างมีข้อจำกัด ไม่ว่าจะใช้ pre-trained models ที่มีจำนวน layer มากขึ้น หรือ มีจำนวน hidden units เพิ่มขึ้น มักพบว่าหลังจาก transfer learning แล้ว โมเดลมีความแม่นยำไม่ต่างจากเดิมมากนัก หรือก็คือ โมเดลไม่สามารถใช้ประโยชน์จาก pre-trained models ได้ แม้ว่าจะใช้โมเดลที่เก่งขึ้น
สาเหตุหนึ่งอาจจะมาจากเหตุผลที่ว่า เมื่อทำ feature extraction แล้วเวกเตอร์ที่ได้มาเป็นค่าตายตัว ไม่สามารถอัพเดตตัวเองให้เข้ากับปัญหาใหม่ได้ แต่ในทางกลับกัน การ fine-tuning อนุญาตให้แก้ไข pre-trained model ได้ด้วย จึงสามารถใช้ประโยชน์จาก pre-trained model ได้มากกว่า
แต่อย่างไรก็ตาม การทดลองในเปเปอร์ BERT แสดงให้เห็นว่า การทำ Feature Extraction ก็ไม่ได้แย่ไปซะทีเดียว โดยเฉลี่ยแล้วมีความแม่นยำต่างกับการ Fine-tuning เพียง 0.3 (F1 score) เท่านั้นเอง
ดังนั้นในระบบที่มีข้อจำกัดทางทรัพยากร การใช้ feature extration ก็อาจจะเป็นอีกหนึ่งตัวเลือกที่น่าสนใจ
Is MLM & NSP really work?
คำถามที่ทุกคนอาจจะคิดอยู่ในใจ คือ MLM & NSP ที่พูดๆมาทั้งหมด เป็นส่วนช่วยให้ BERT ทำงานได้ดีจริงๆเหรอ? หรือเป็นแค่เพราะว่า BERT มีขนาดใหญ่
เปเปอร์เปรียบเทียบประสิทธิภาพของ BERT ด้วย โมเดลขนาดเท่าๆกันแต่สอนด้วยบริบททางเดียว (แทนด้วยชื่อ LTR) และพบว่า BERT สามารถเอาชนะ LTR ไปได้ ด้วยความแม่นยำที่เพิ่มขึ้นถึง 2–4% ในทุกๆบททดสอบ โดยเฉพาะบททดสอบ MRPC และ SQuAD ซึ่งเป็นปัญหา Semantic Textual Similarity และ Question Answering ซึ่งต้องอาศัยความเข้าใจบริบทภาพรวม
และนอกจากนี้ ยังพบว่า ทั้ง MLM และ NSP ต่างมีส่วนช่วยในการเพิ่มความแม่นยำของโมเดล แต่ทั้งนี้ NSP มีส่วนช่วยแค่ในบางบททดสอบ โดยเฉพาะบททดสอบที่เป็นปัญหาในระดับประโยค (Sentence-level tasks)
อย่างไรก็ตาม MLM ก็ไม่ได้เป็นคำตอบสุดท้ายของทุกอย่าง ข้อจำกัดสำคัญของ MLM คือ ความต้องการทรัพยากรในการคำนวนที่มากกว่า LM เพื่อให้ได้ความแม่นยำที่ดีที่สุด แต่เมื่อเทียบขณะที่ใช้ทรัพยากรการคำนวนที่เท่าๆกัน MLM สามารถทำงานได้ดีกว่า LM (MLM does converge slower but it achieves a much higher accuracy with the same number of steps)
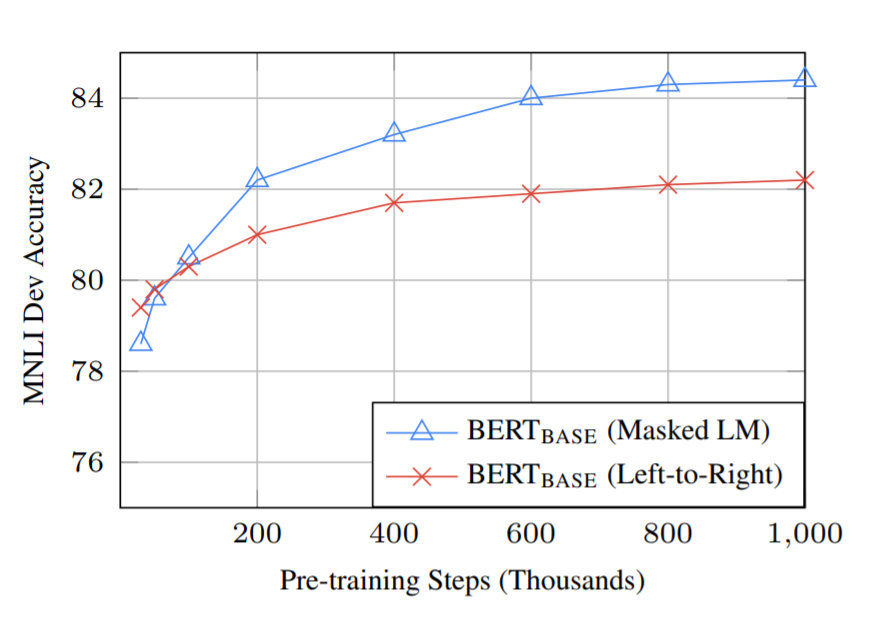
ในขณะที่ training steps เท่ากัน MLM สามารถแก้ปัญหาด้วยความแม่นยำที่สูงกว่า LTR แต่เพื่อให้ได้ประสิทธิภาพที่ดีที่สุด MLM ต้องใช้ training steps มากกว่า LTR
ทั้งนี้ เหตุผลส่วนหนึ่ง อาจจะมาจากเหตุผลที่ว่า ในแต่ละรอบของการสอน MLM จะคำนวน Loss จากแค่ใน 15% ของคำทั้งหมด แต่กลับกัน LM สามารถคำนวน Loss จากทุกๆคำ
Take away
- การใช้ประโยชน์จากโมเดลทาง NLP ไม่ได้เป็นเรื่องยุ่งยากอีกต่อไป สามารถใช้ไลบรารี่อย่าง HuggingFace ก็สามารถ fine-tuning โมเดลได้ในไม่กี่บรรทัด
- แนวโน้มหนึ่งที่เห็นได้ชัดมากขึ้น คือ ยิ่งโมเดลมีขนาดใหญ่ ยิ่งมีความสามารถเพิ่มขึ้น แต่โมเดลขนาดใหญ่พวกนี้ ต้องใช้ข้อมูล และ ทรัพยากรในการเทรน อย่าง GPU จำนวนมาก ทำให้มีเพียงบริษัทที่มีทุนมากๆสามารถสร้างโมเดลในลักษณะนี้ได้ แต่ทั้งนี้ การมีอยู่ของเทคนิค Transfer Learning เป็นการเปิดโอกาสให้บุคคลทั่วไป นักวิจัย และบริษัทขนาดเล็กสามารถเข้าถึงเทคโนโลยีนี้ได้ (Fairness)
- ถึงแม้ว่า BERT แสดงให้เห็นถึงประสิทธิภาพในการแก้ปัญหาจำนวนมาก แต่ปัญหาที่ BERT ทดสอบ เป็นเพียงปัญหาในกลุ่ม NLU (Natural Language Understanding) ยังมีปัญหากลุ่มใหญ่อีกกลุ่ม อย่าง NLG (Natural Language Generation) ซึ่งเกี่ยวข้องกับการแต่งประโยค แต่งนิยาย แปลภาษา ย่อความ etc ที่ BERT ไม่สามารถจัดการได้
- ณ เวลาที่เขียนในตอนนี้ มีโมเดลอื่นๆที่แซงหน้า BERT ไปแล้ว อย่าง GPT-3 จาก OpenAI หรือ T5 จาก Google การพัฒนายังคงมีอยู่อย่างต่อเนื่อง อย่าหยุดที่จะเรียนรู้
Credit
ต้องขอขอบคุณ เปเปอร์ต้นฉบับ BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding สำหรับเนื้อหาในวันนี้ และสำหรับข้อมูลเพิ่มเติม
ทั้งนี้ขอขอบคุณผู้อ่านทุกๆคนที่ตามอ่านมาจนถึงตรงนี้ กราบ กราบ กราบ :)
สุดท้ายนี้
1. ผู้เขียนพยายามอย่างเต็มความสามารถ เพื่อที่จะย่อยออกมาเป็นเนื้อหาพอดีคำ แต่กระนั้น มันก็ยังเป็นข้อมูลก้อนโต ถ้ามีส่วนไหนยังมีความมึนๆ หรือ ต้องการให้อธิบายเพิ่มเติม สามารถคอมเม้นได้จ้า
2. ผู้เขียนพึ่งเริ่มศึกษางานวิจัยทางด้านนี้ ถ้ามีข้อมูลส่วนใดผิดพลาด กรุณาอย่าด่าแรง และ ขออภัยมา ณ ที่นี้ และเช่นเดียวกันกับข้อ 1) ยินดีรับฟังคอมเม้น เพื่อผู้เขียนจะได้นำไปปรัปปรุงในโอกาสถัดๆไป :)